模型接入与协议统一
APIPIG 将 OpenAI、Claude、Gemini、Qwen、DeepSeek、Ollama 等上游接口统一接入,业务系统只需维护一个网关入口即可调用不同模型。
支持的上游
| 类别 | 示例 |
|---|---|
| 海外主流模型 | OpenAI(GPT 系列)、Anthropic Claude、Google Gemini |
| 国产模型 | 通义千问 Qwen、DeepSeek,以及其他兼容 OpenAI 协议的服务 |
| 本地 / 私有部署 | Ollama 本地节点、自建推理服务、私有代理通道 |
对外统一 OpenAI 兼容协议
APIPIG 对外统一提供 OpenAI 兼容协议。无论上游是哪家模型,业务侧都使用同一套请求格式调用:
POST /v1/chat/completions
POST /v1/embeddings
POST /v1/completions
现有基于 OpenAI SDK 的代码只需将 base_url 指向网关地址,无需为每个上游单独适配。
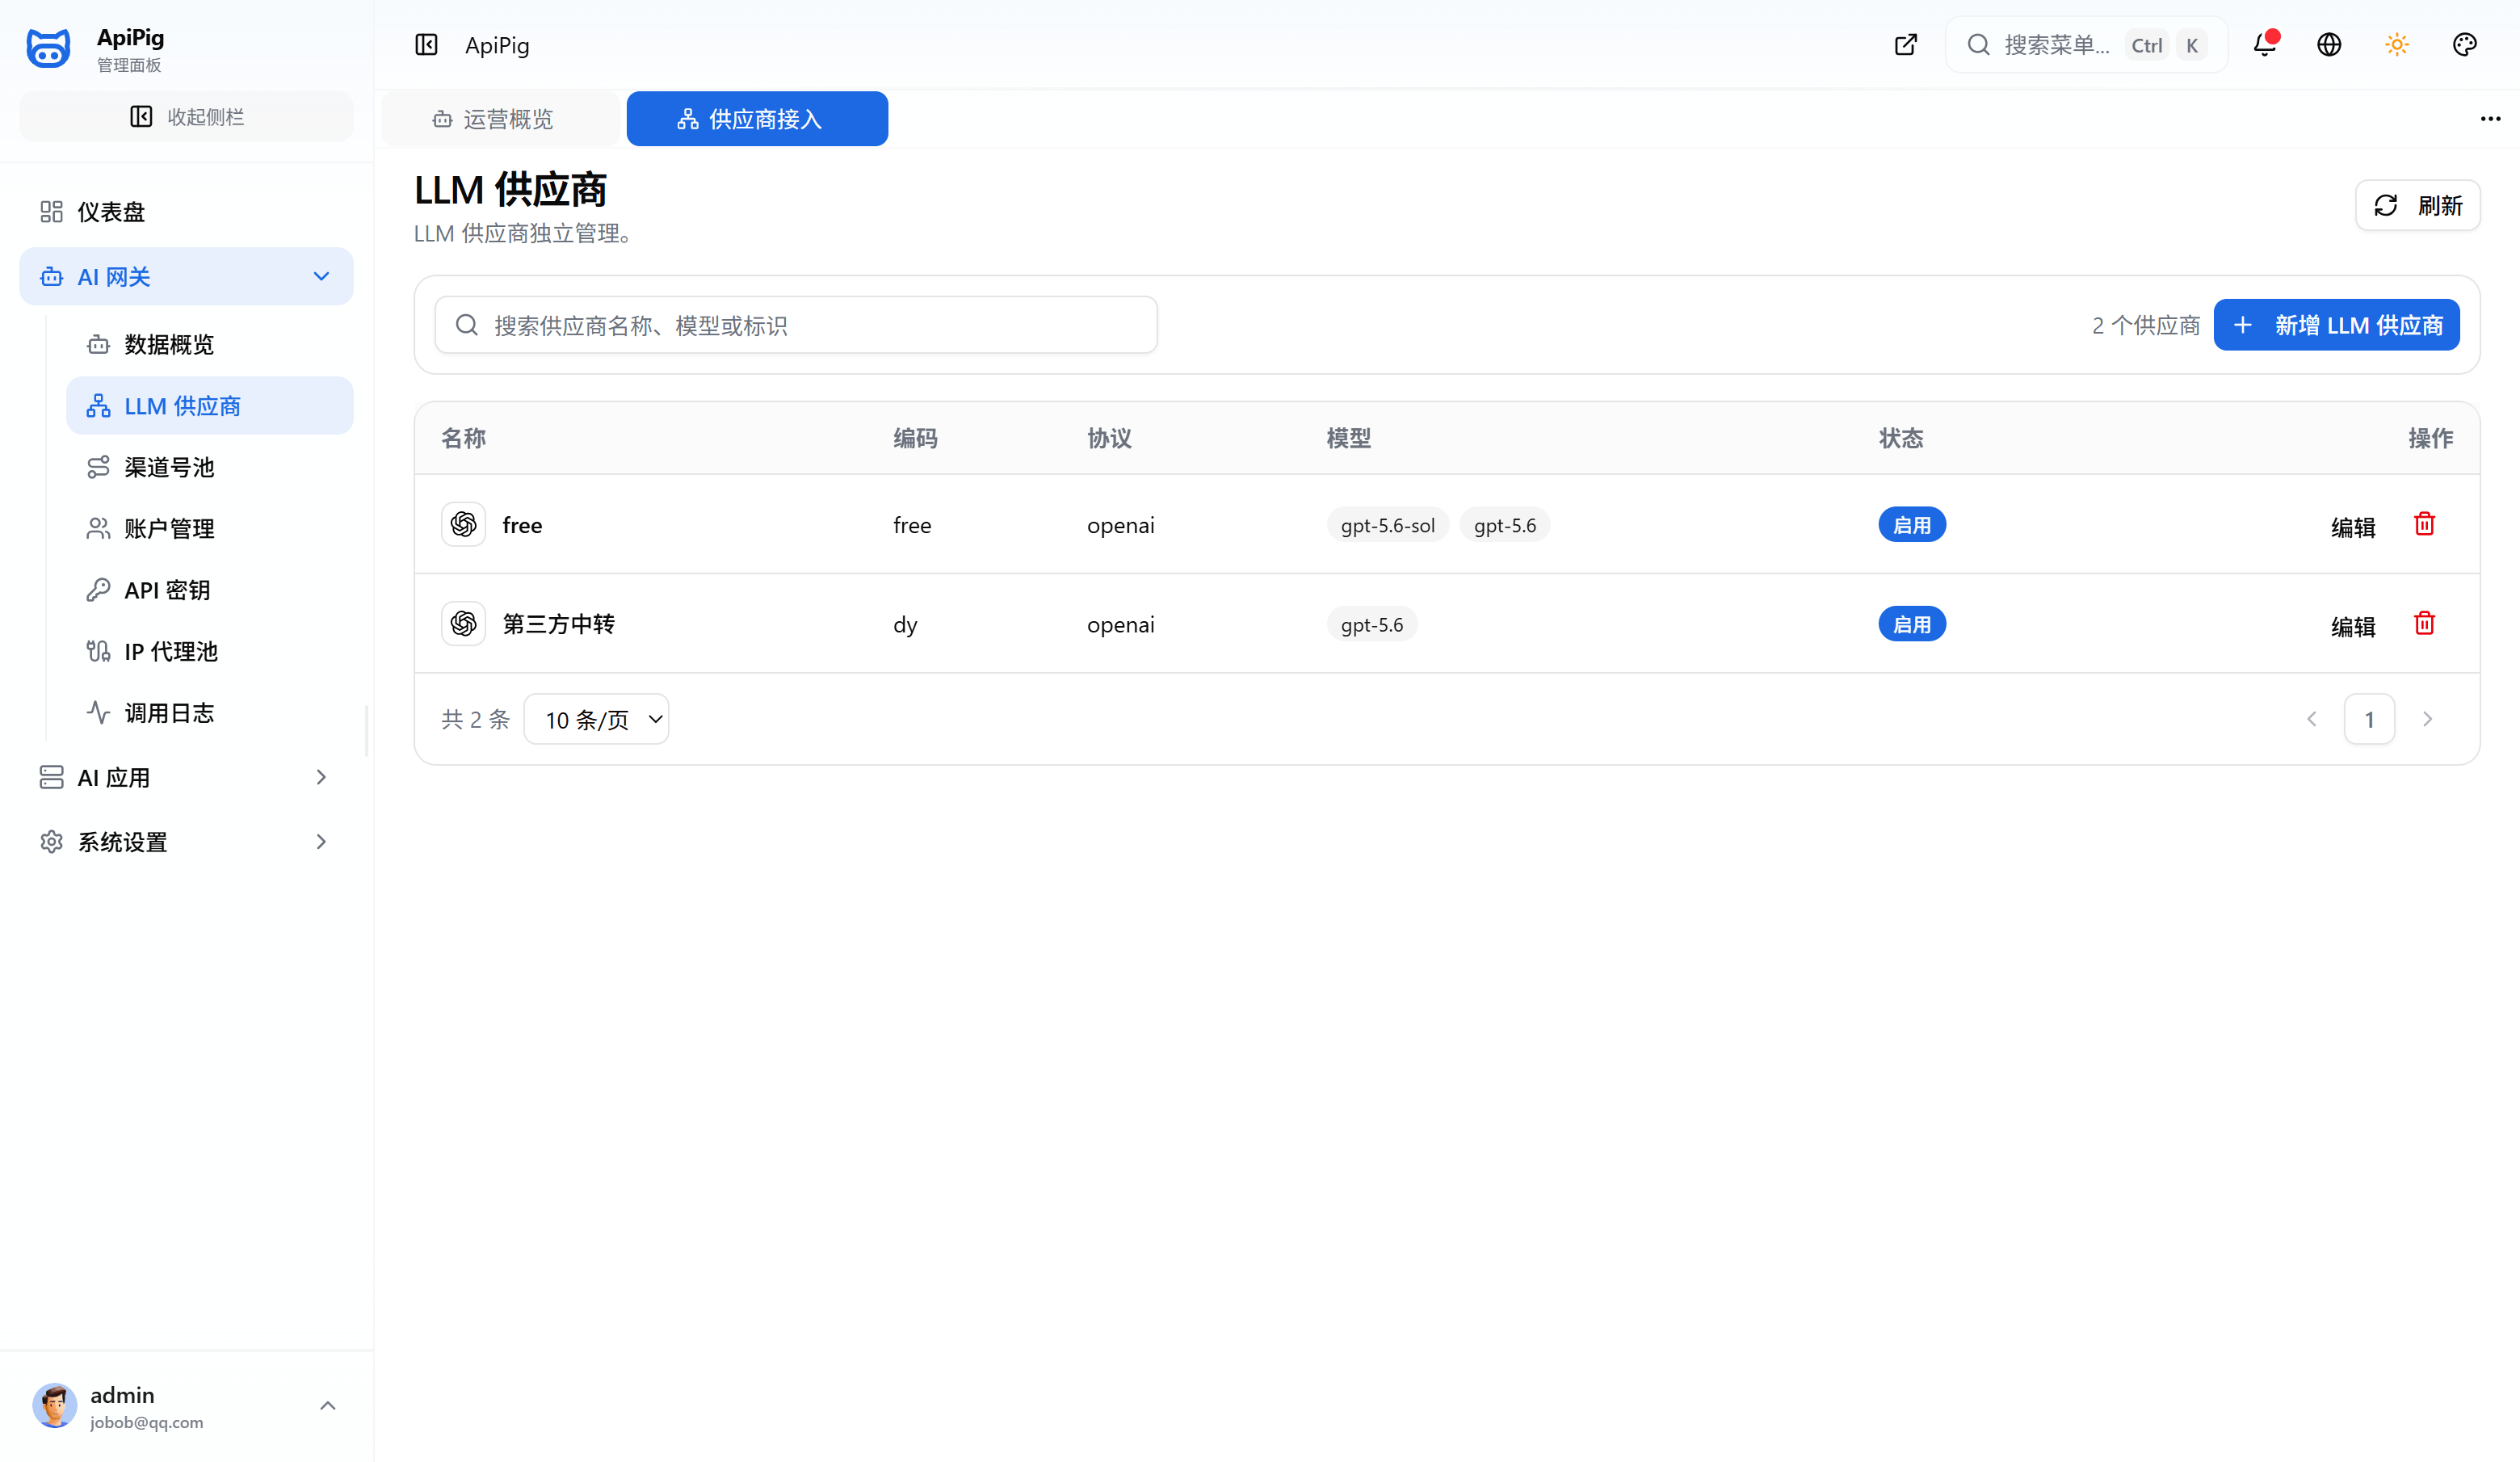
配置 LLM 供应商
首先配置 LLM 供应商,明确上游协议、API 基础地址和支持的模型列表。后续渠道配置会依据这里维护的模型列表进行匹配。
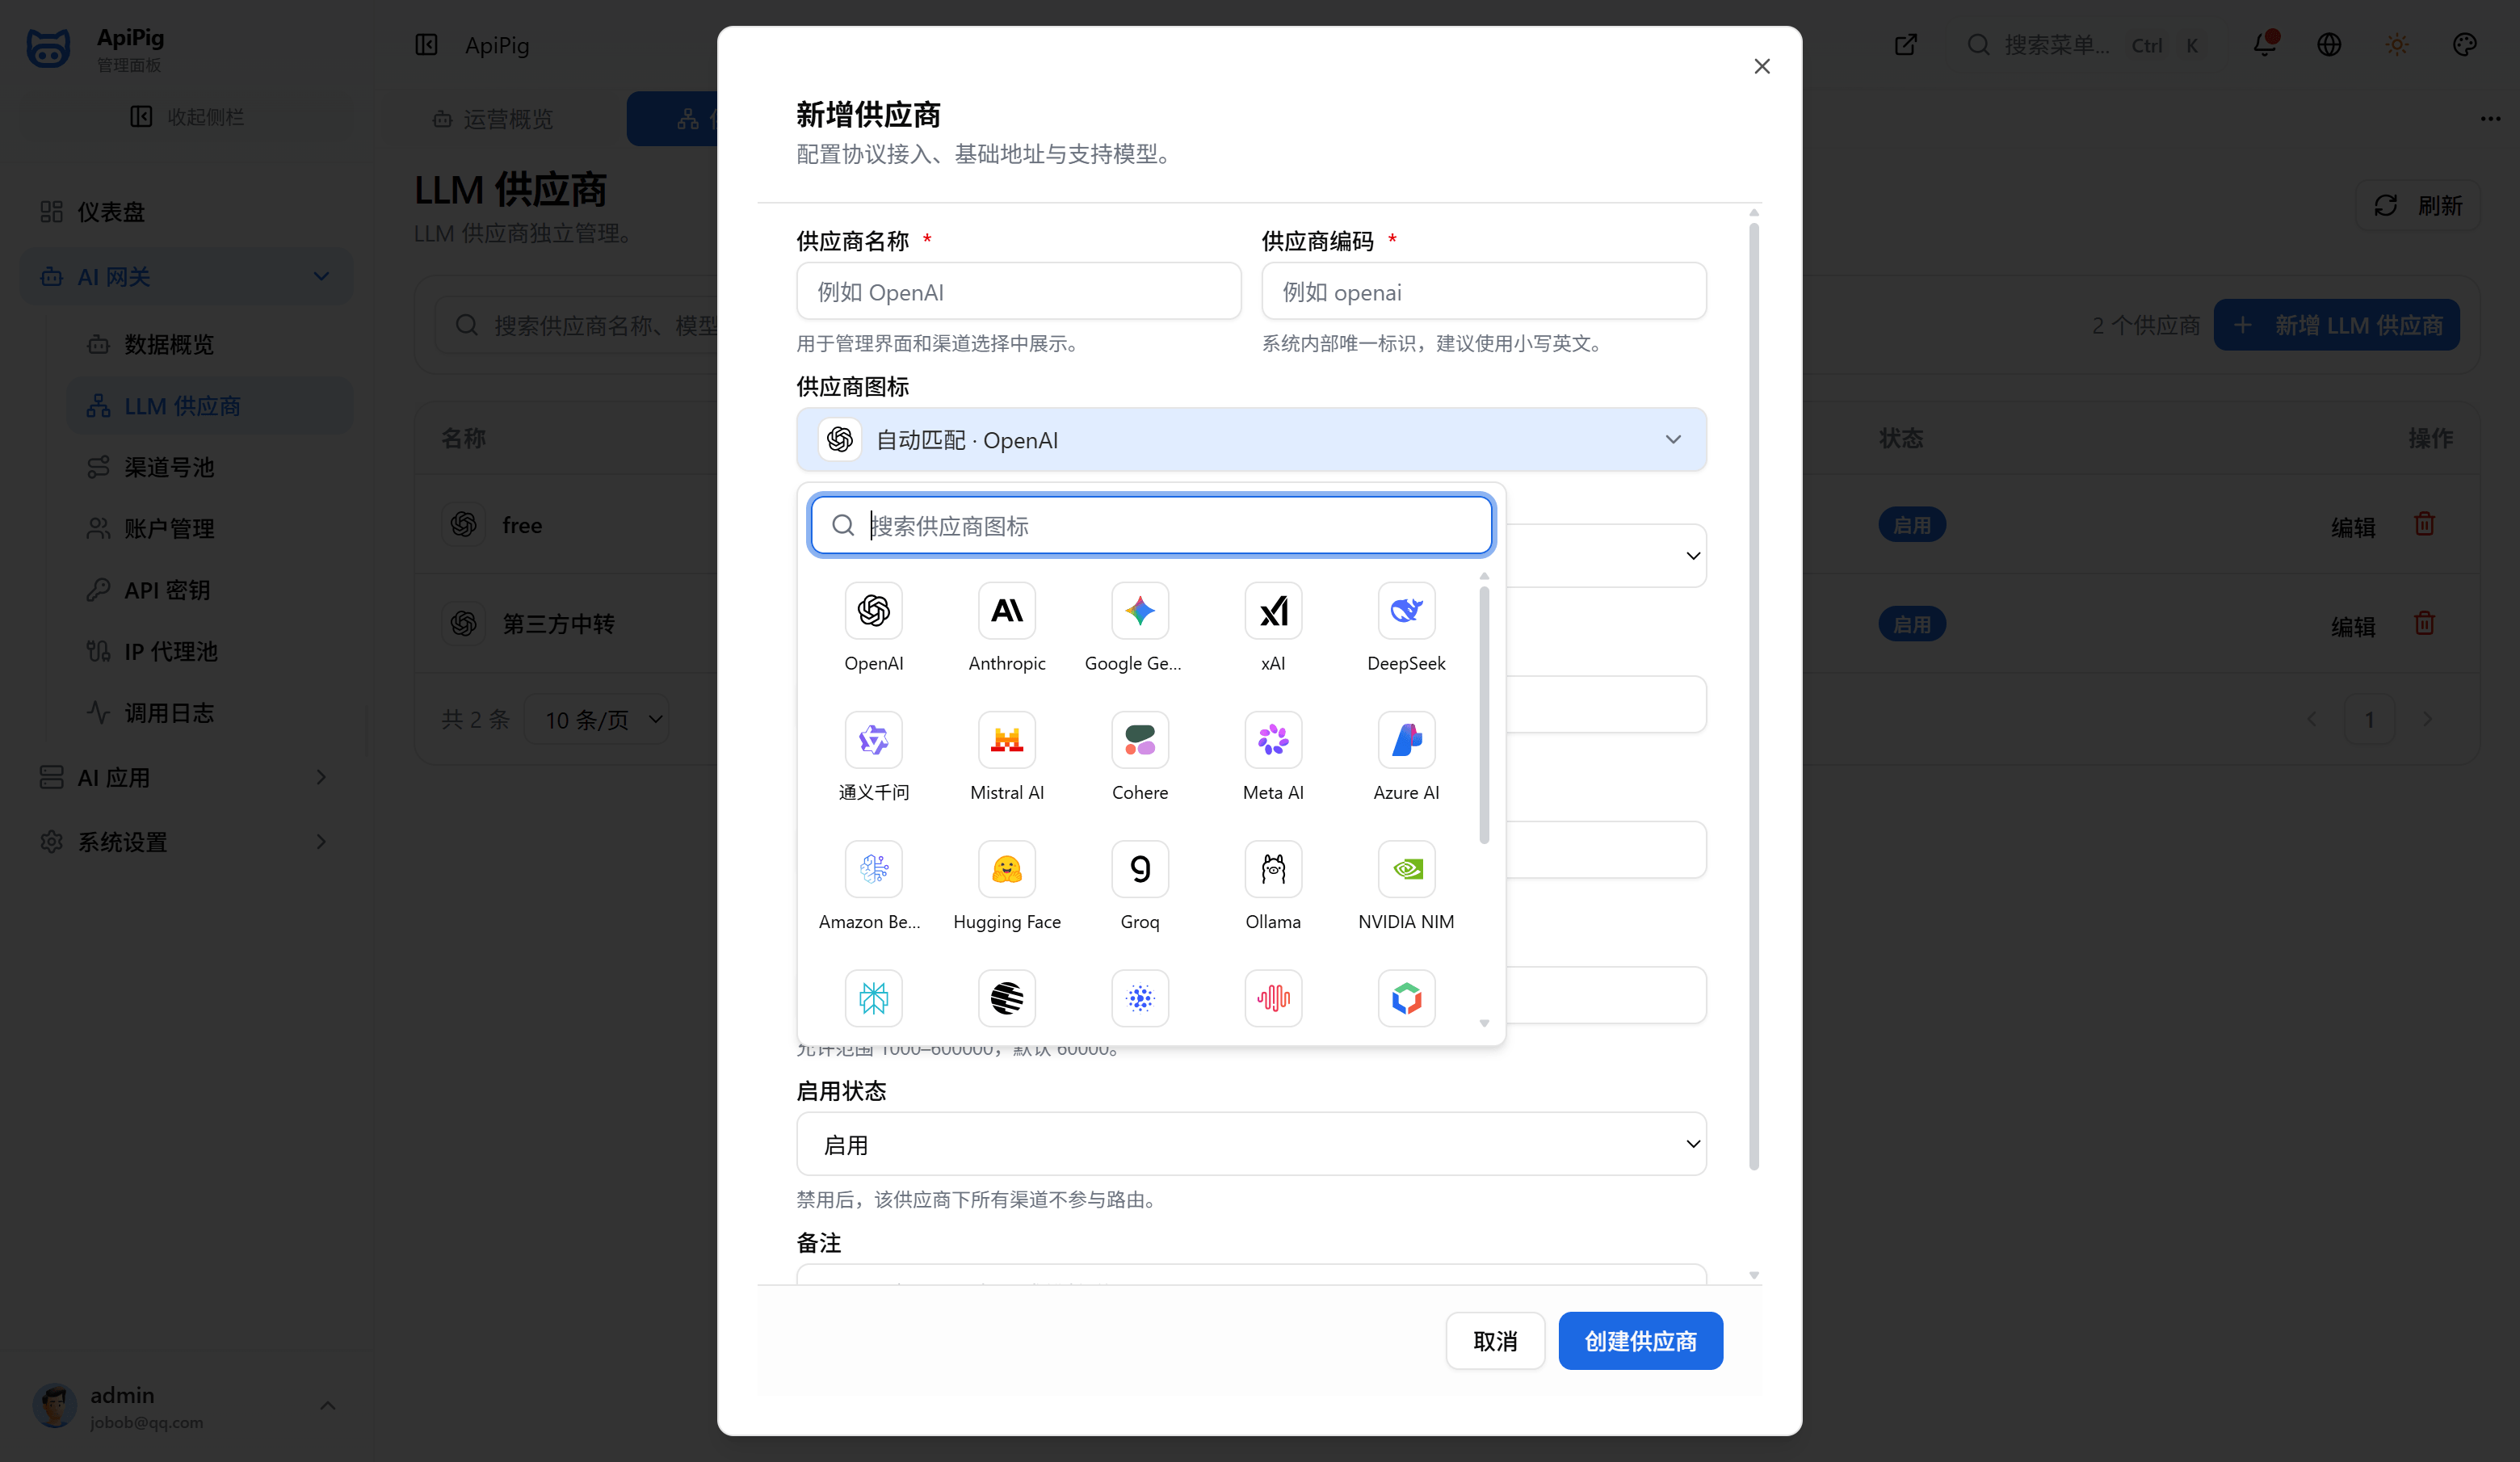
请准确维护供应商的
支持模型列表,否则后续模型选择和调用统计可能不准确。
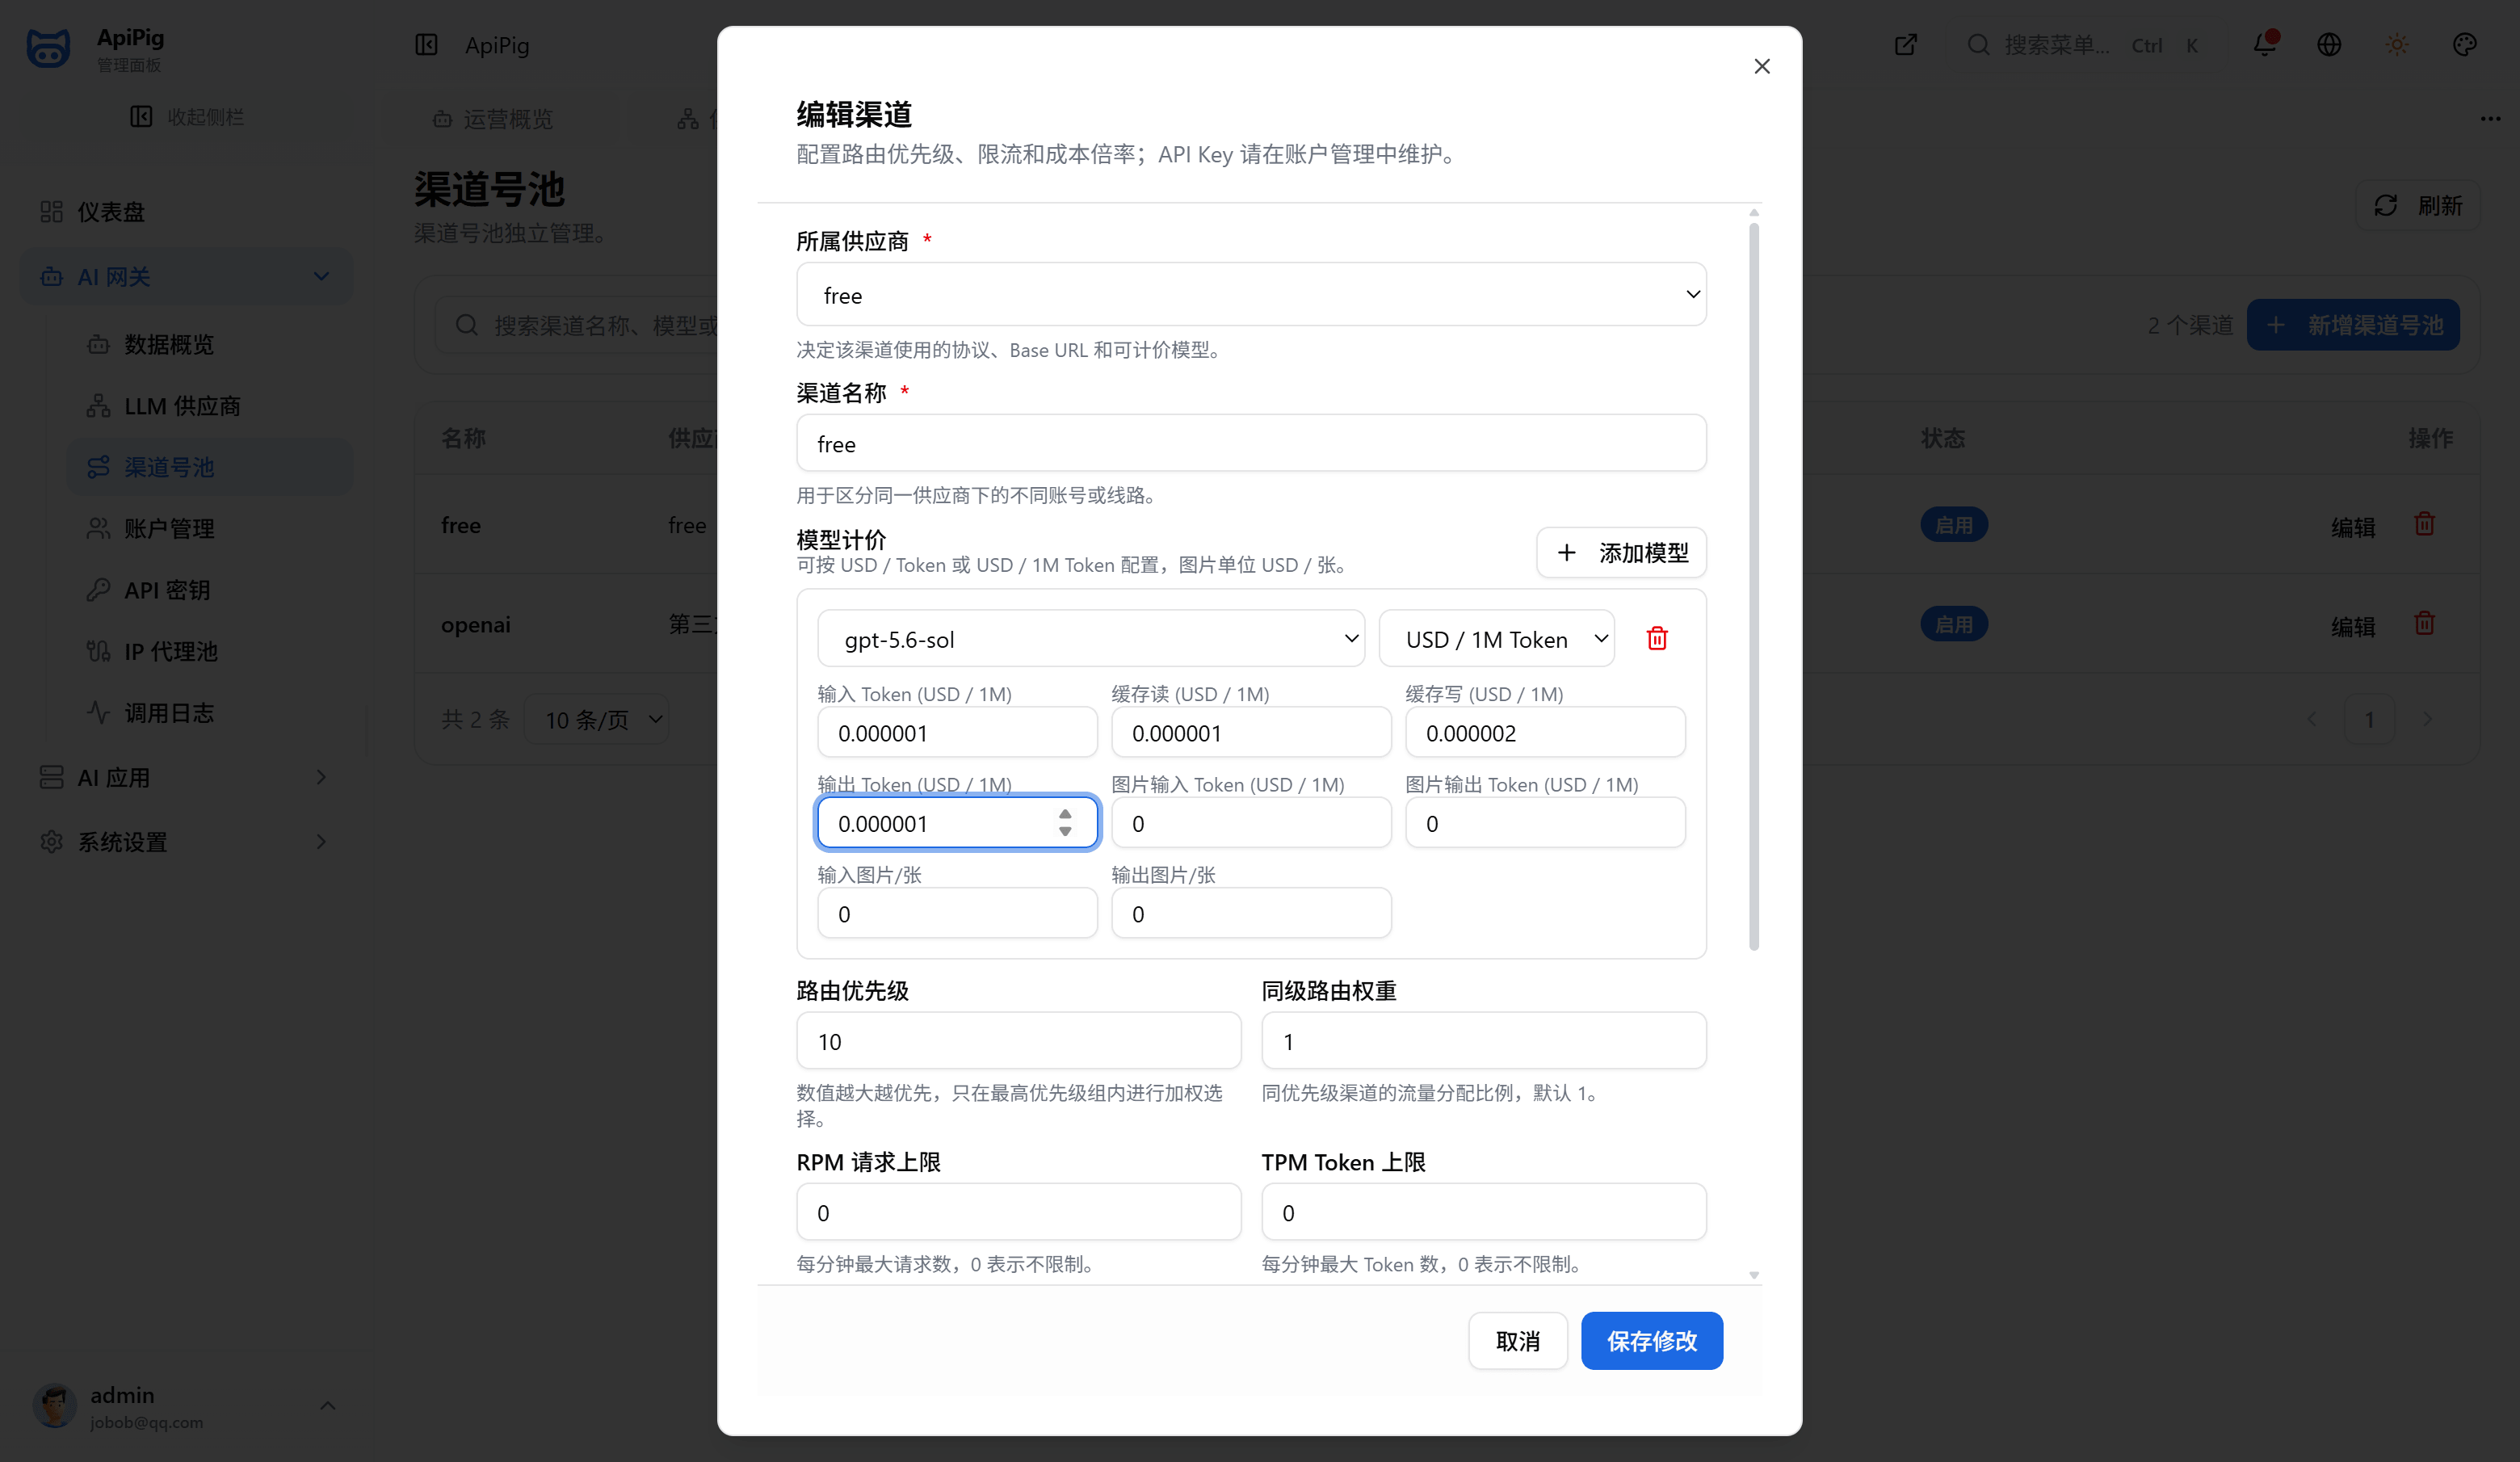
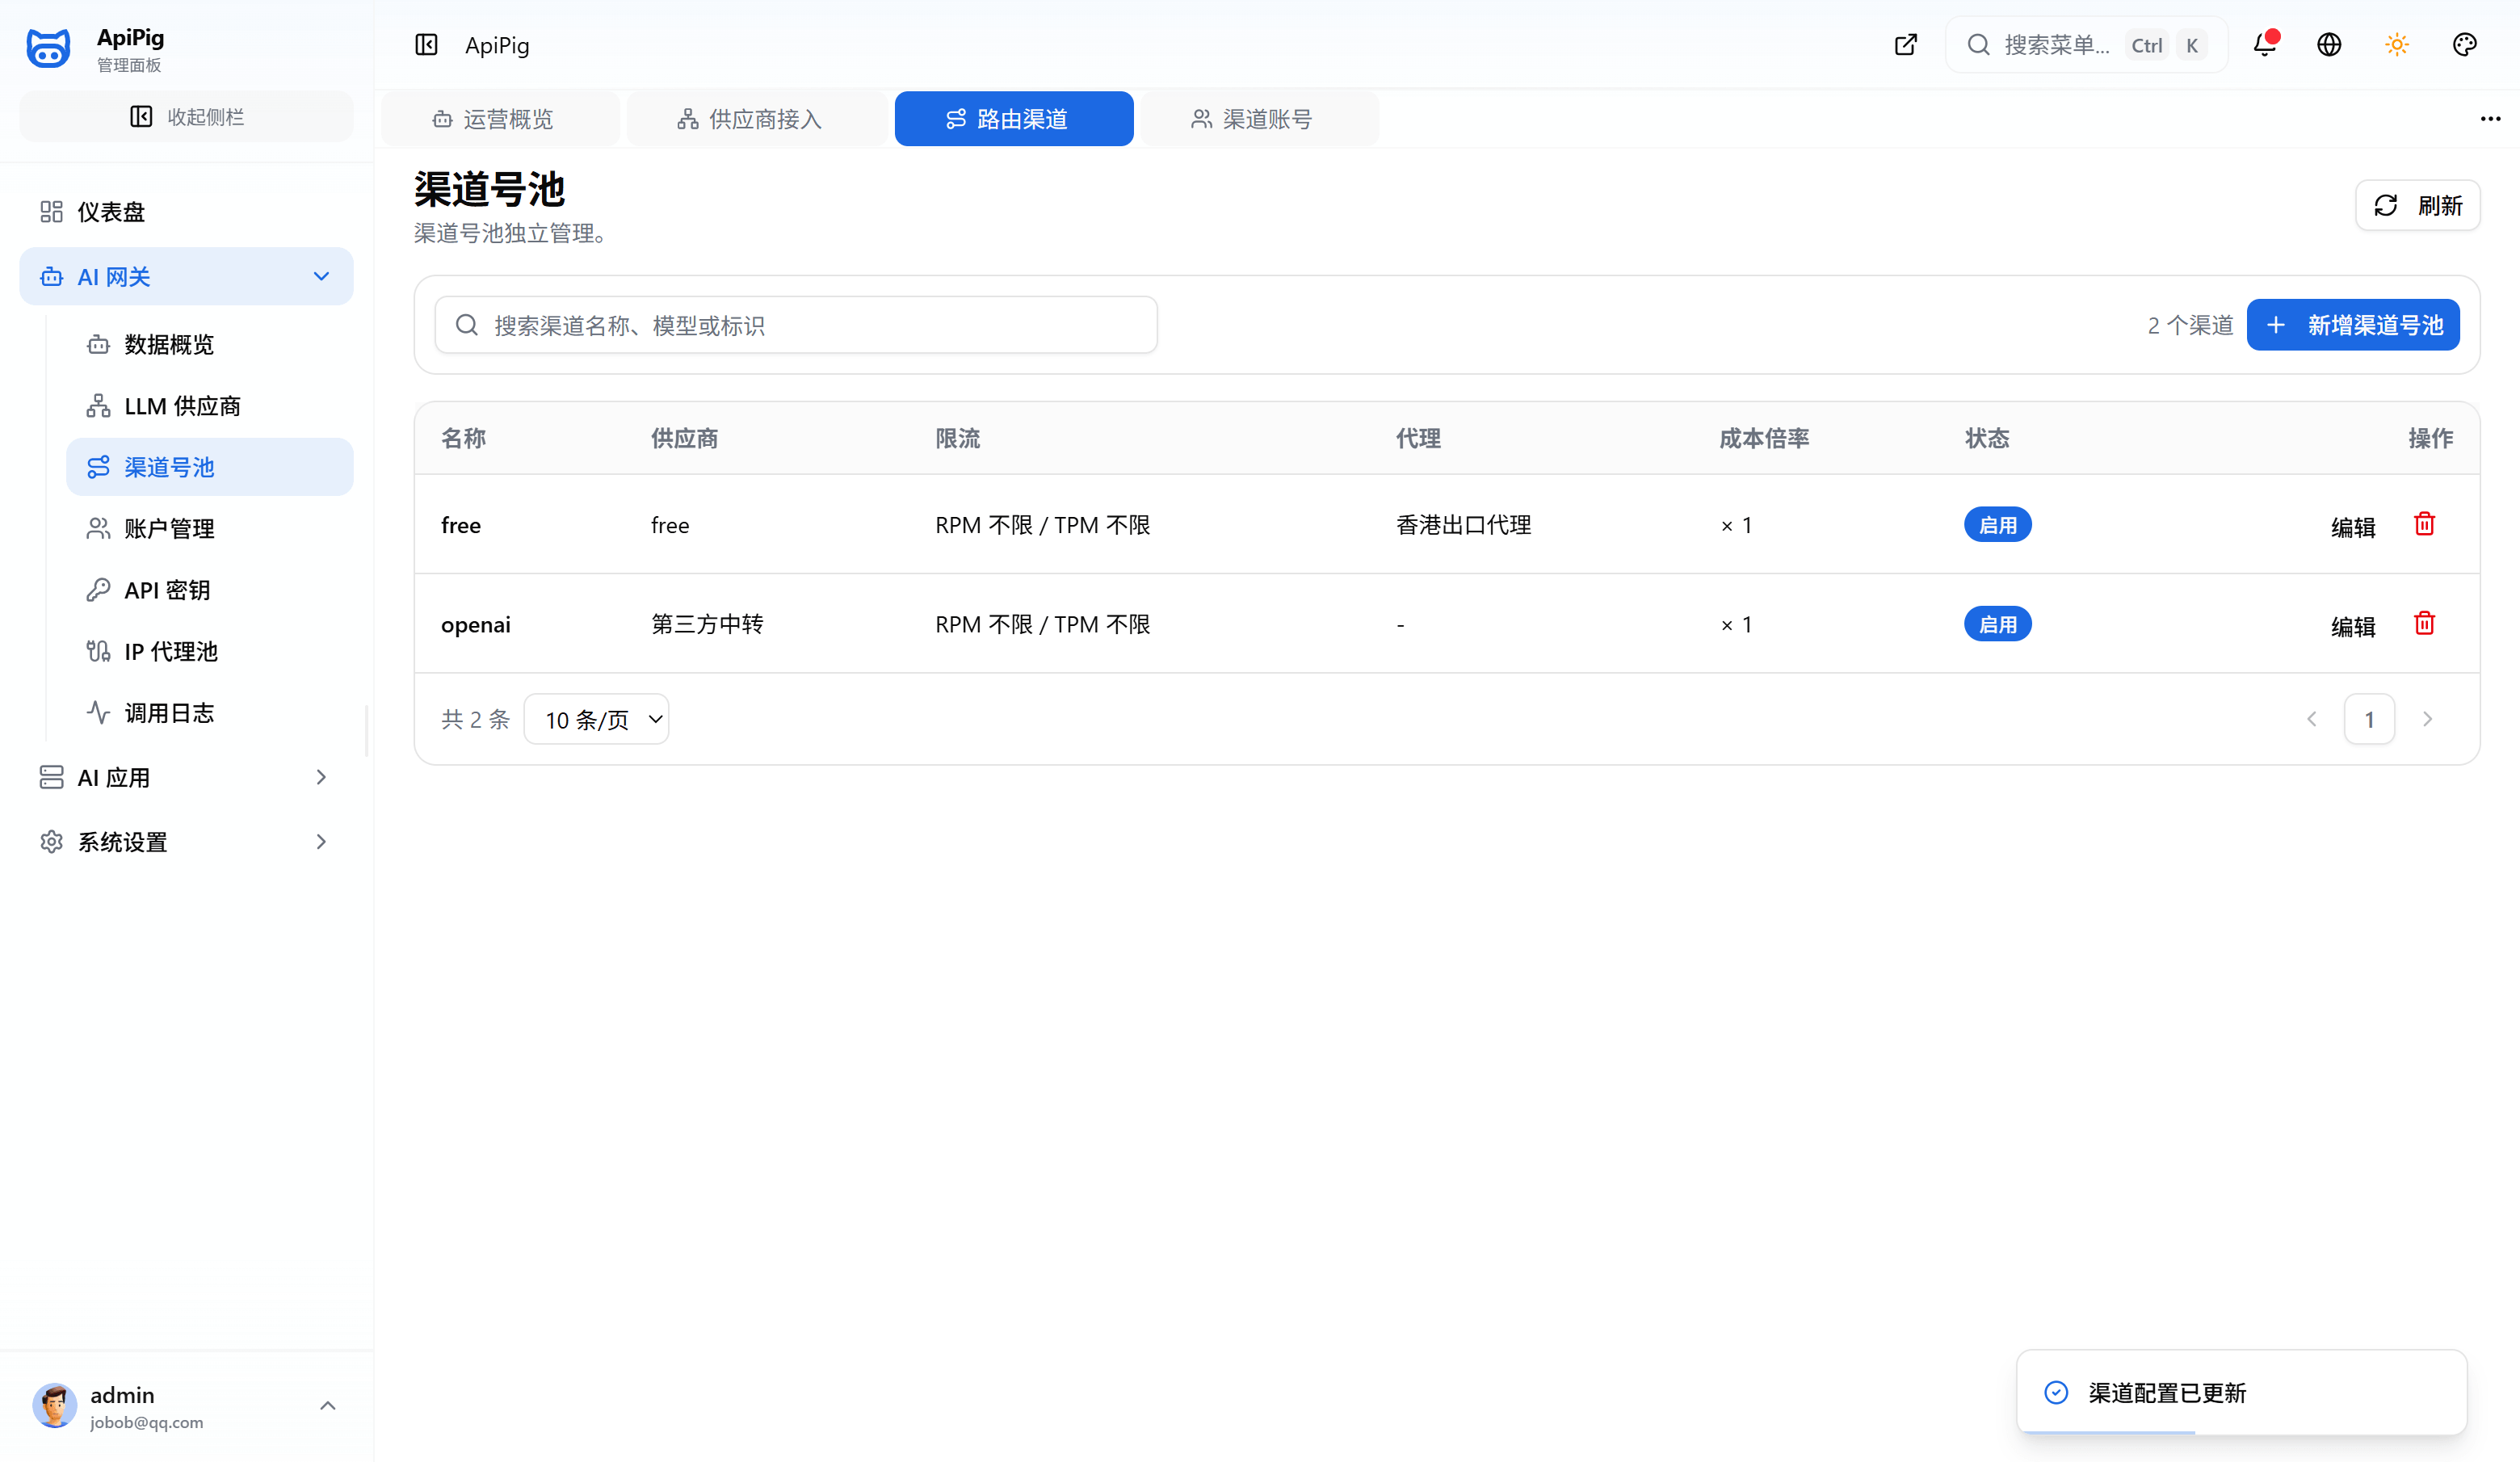
配置渠道账号池
配置渠道账号池时,请确保 模型计价 与渠道的实际计价保持一致,否则模型用量和费用统计会出现偏差。
新增渠道账号
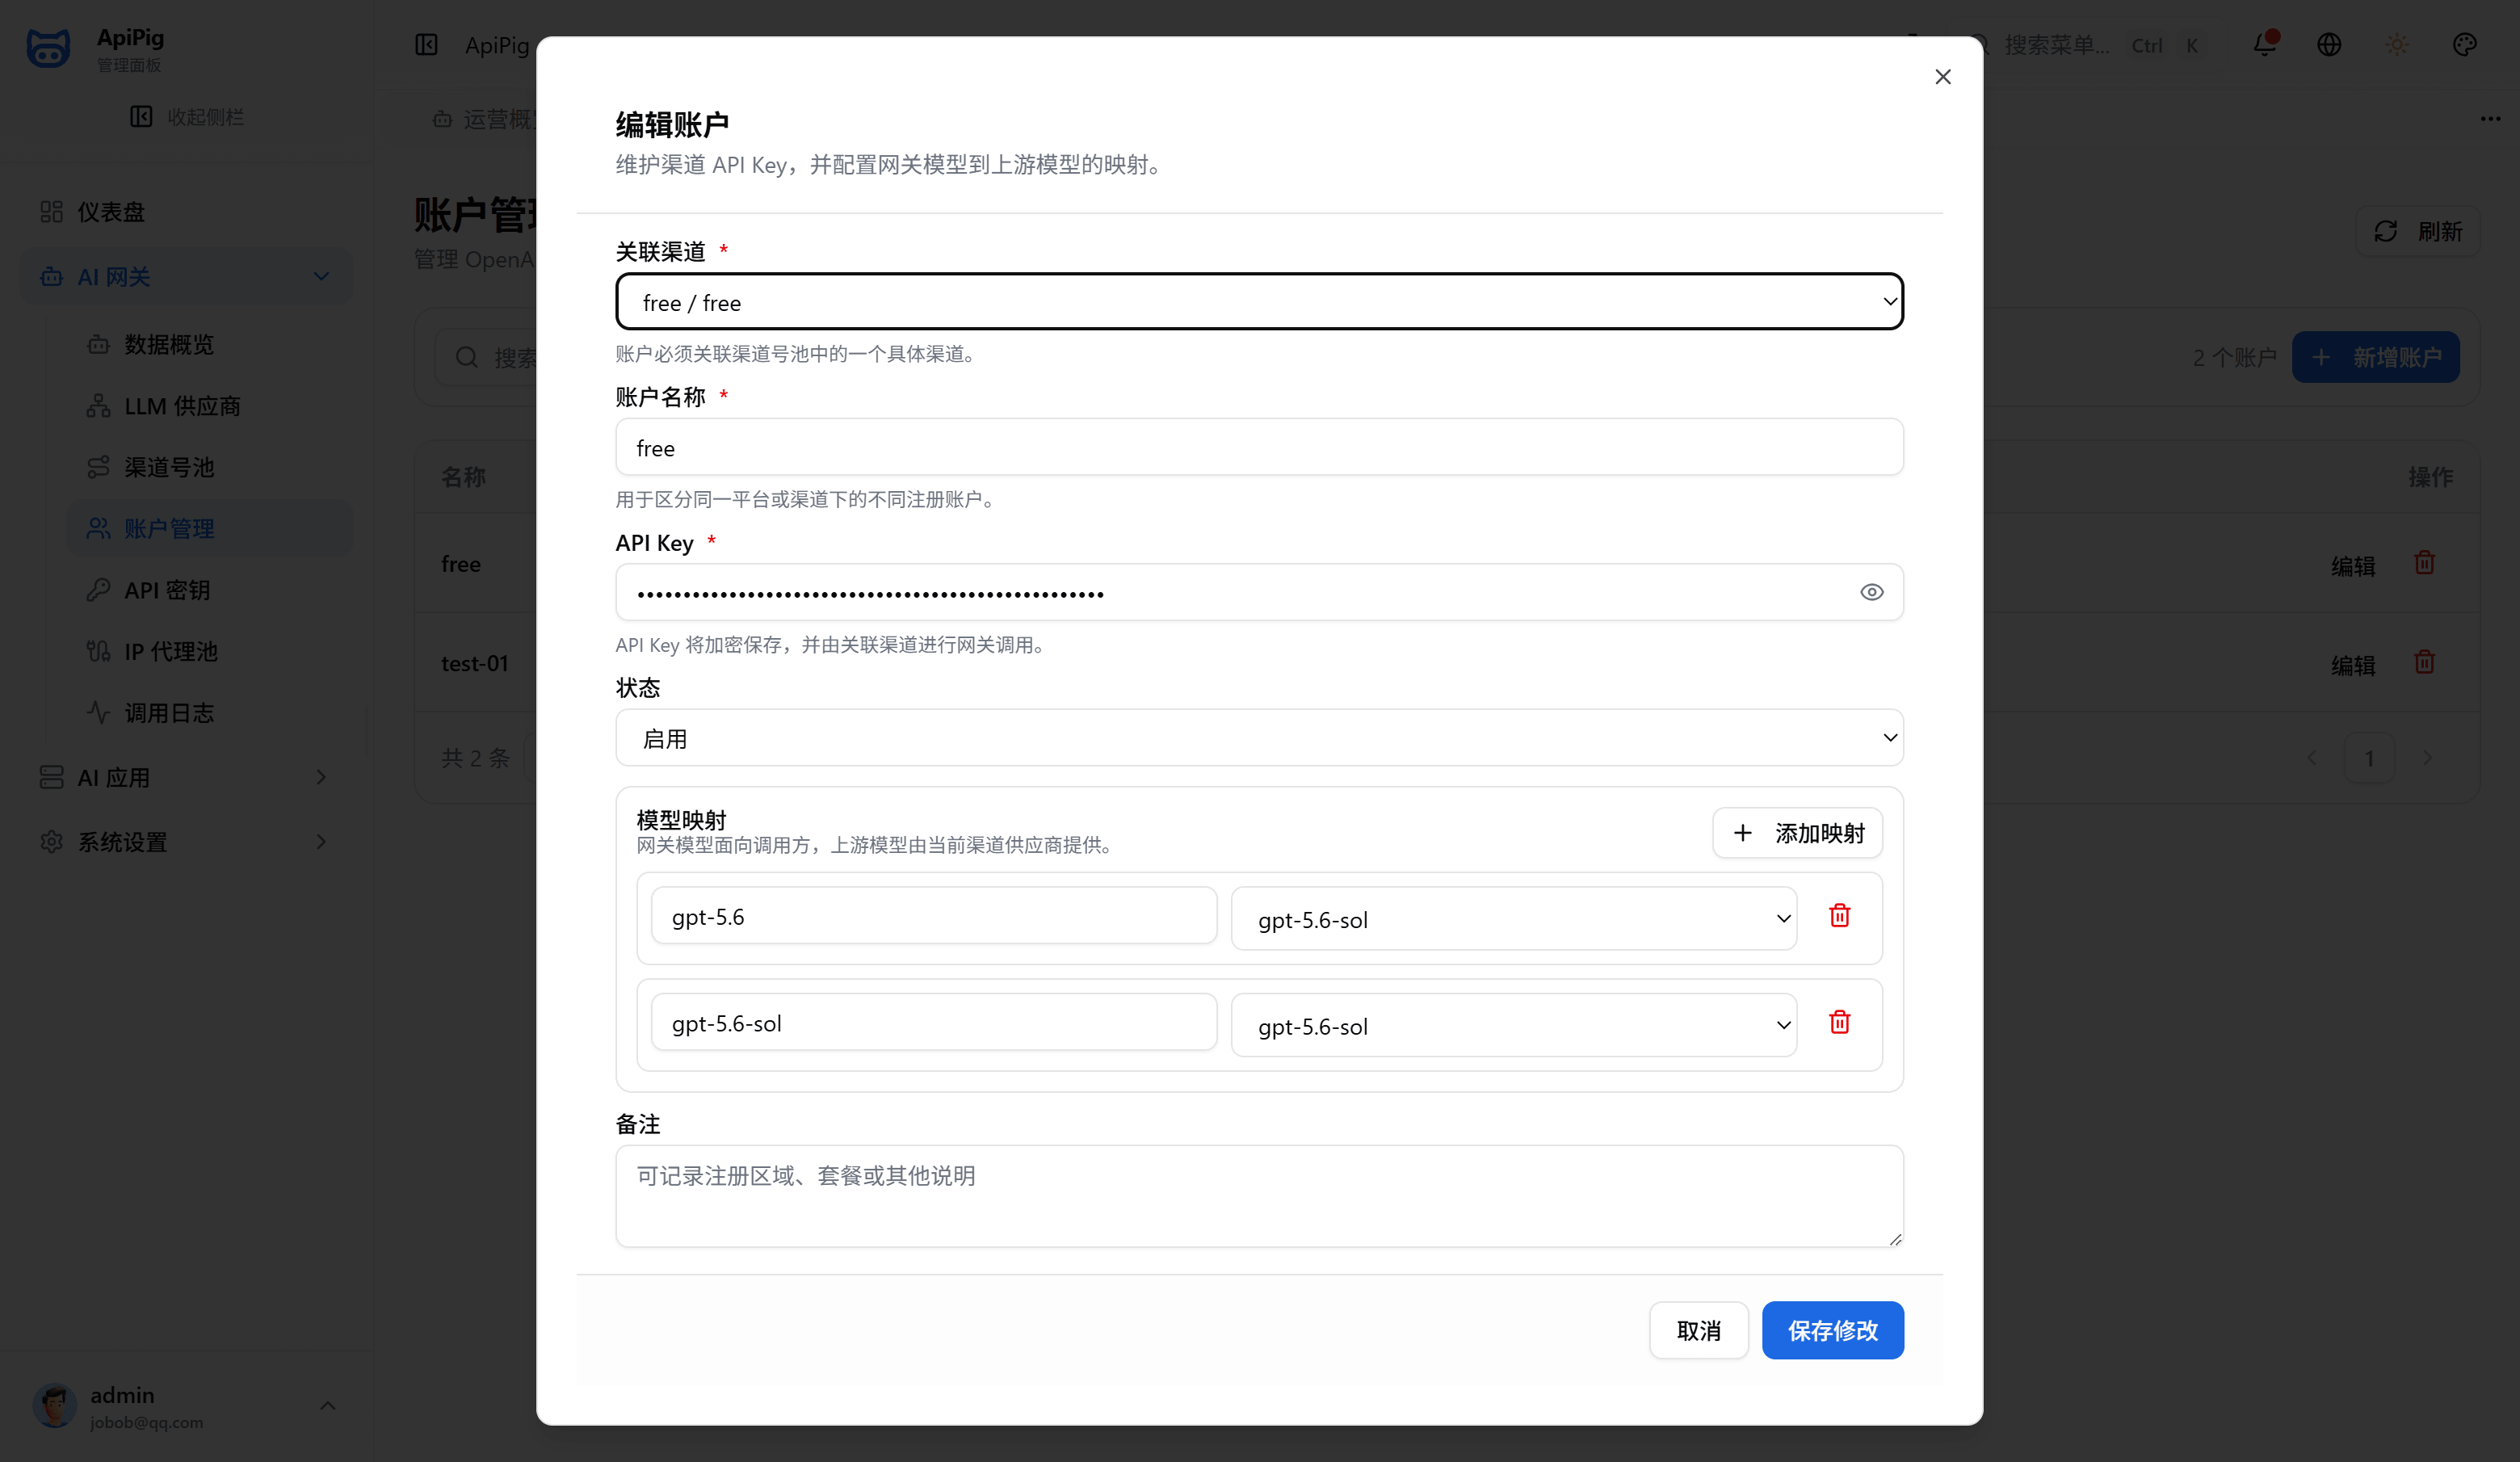
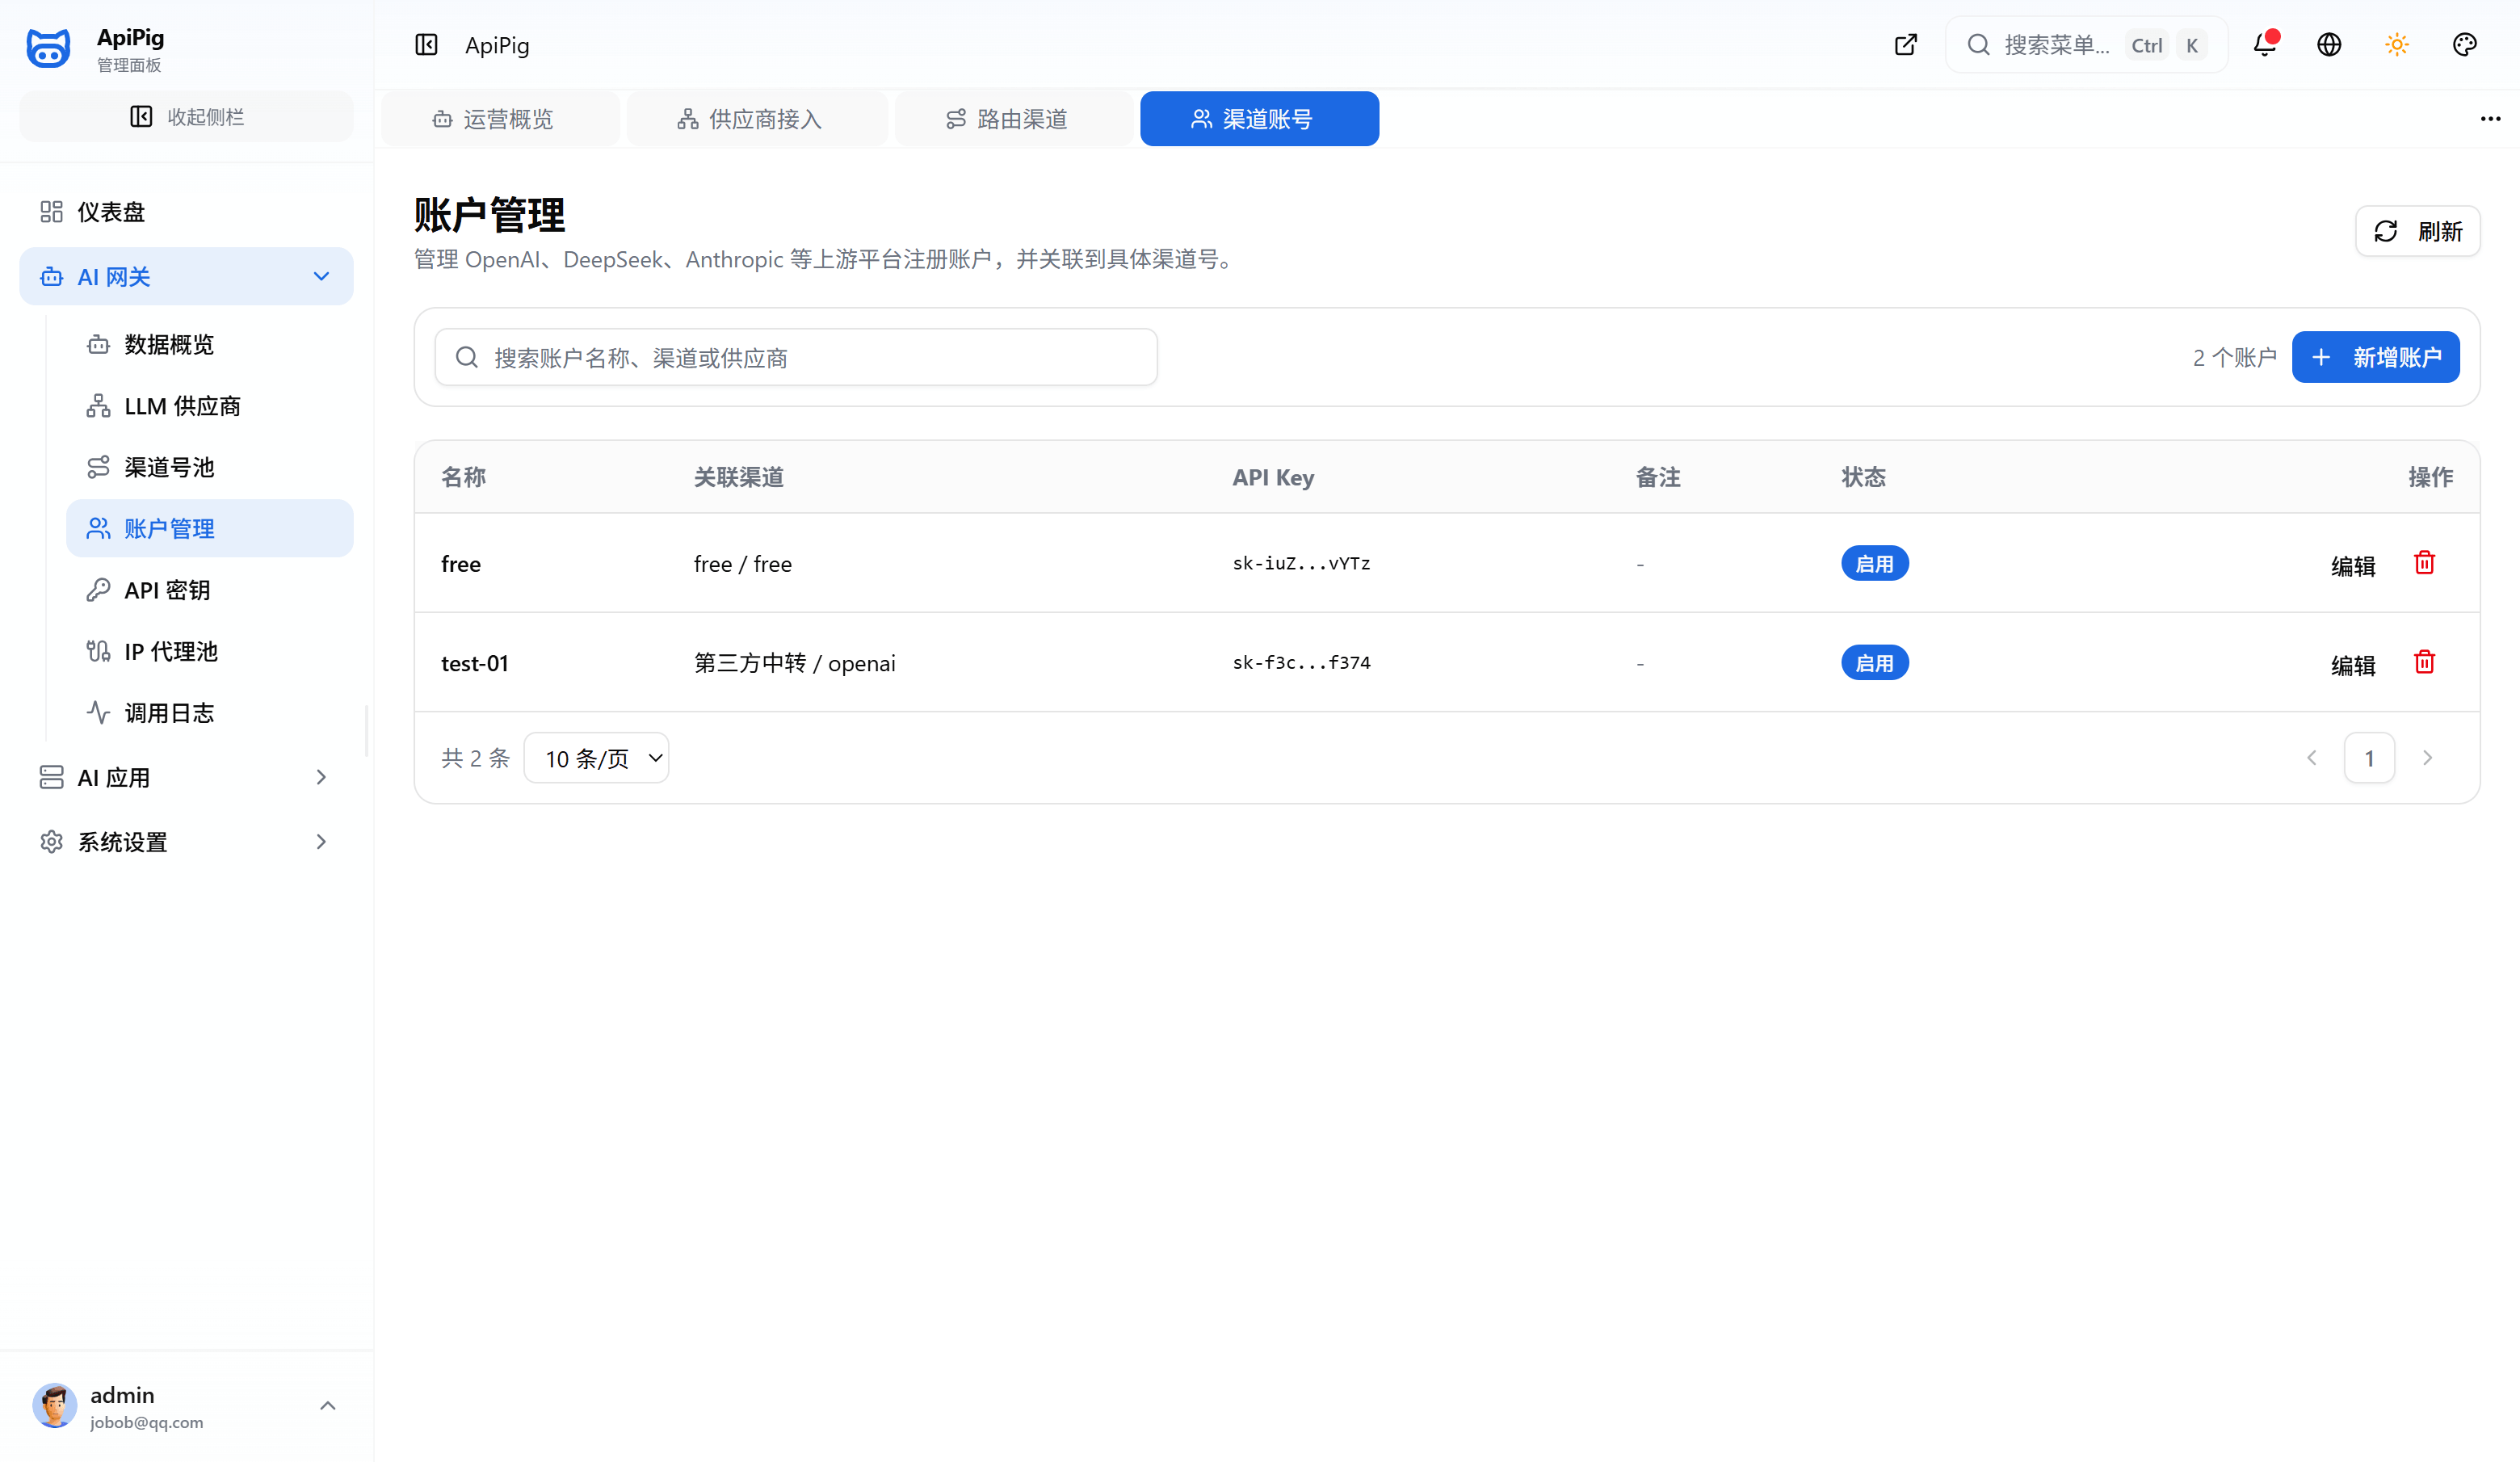
新增渠道账号时,请确认 API Key 有效,并选择该账号允许使用的模型;如上下游模型名称不一致,可通过 模型映射 调整对应关系。
配置 API 密钥
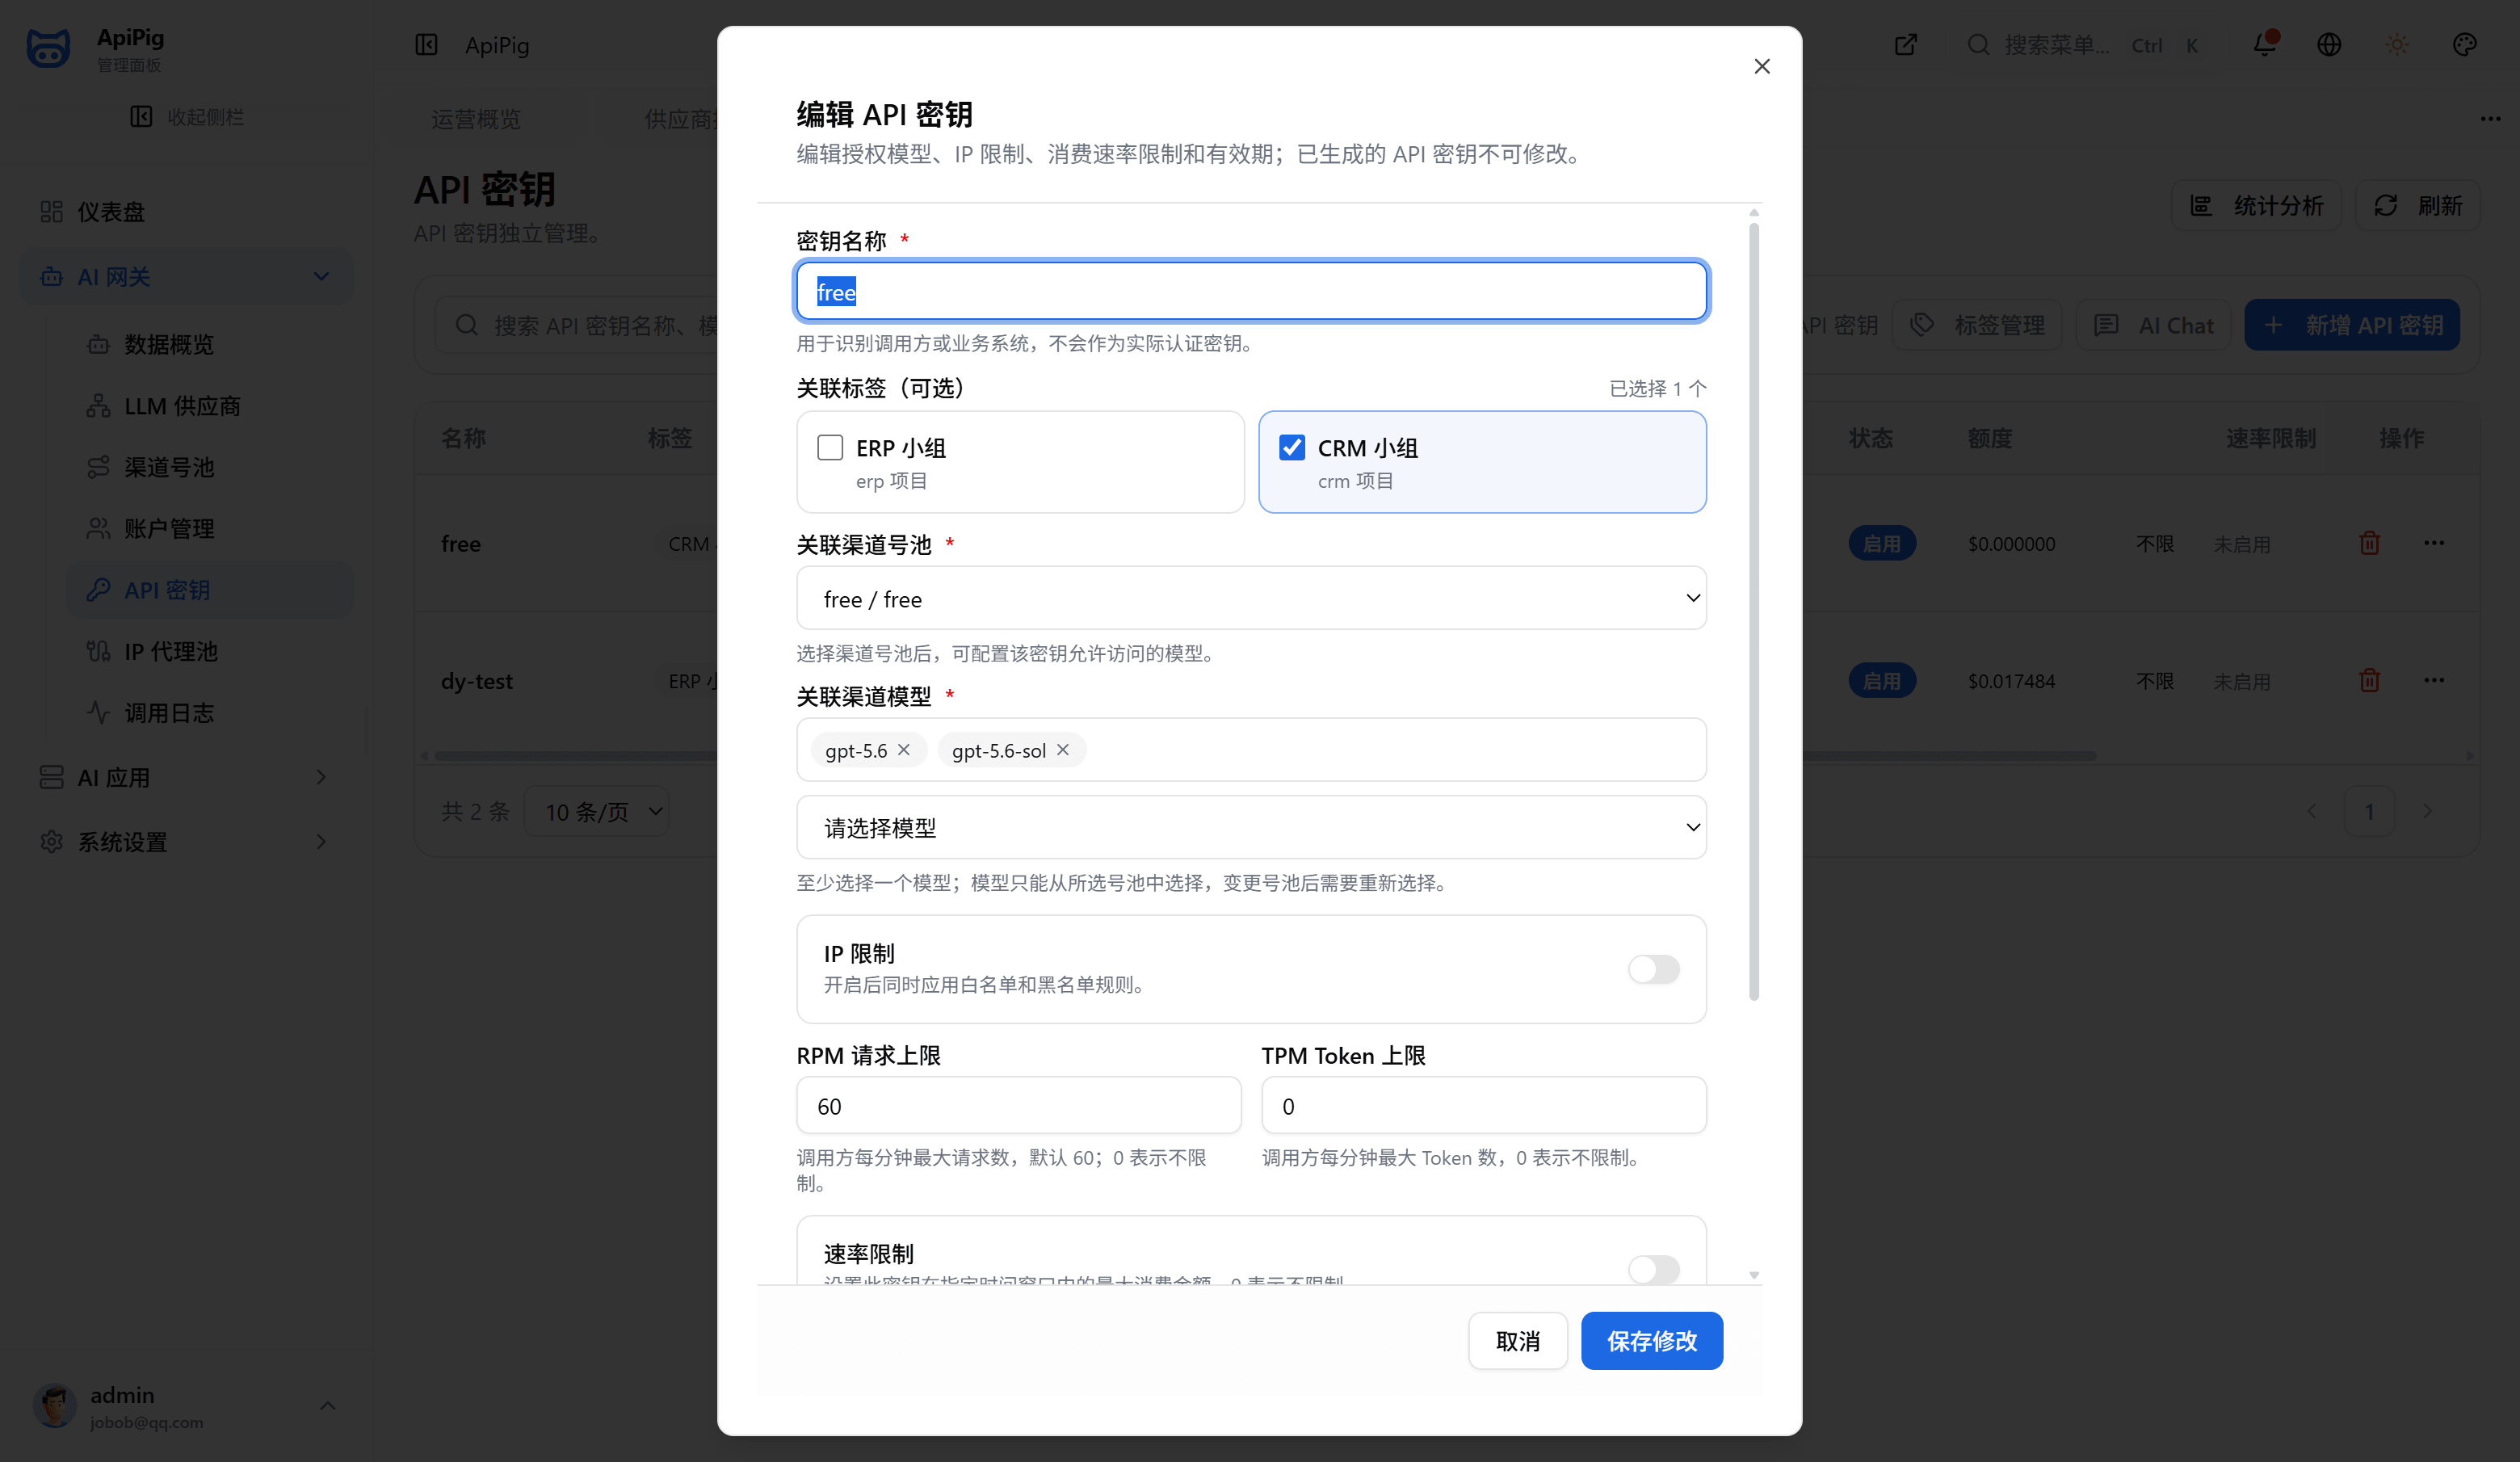
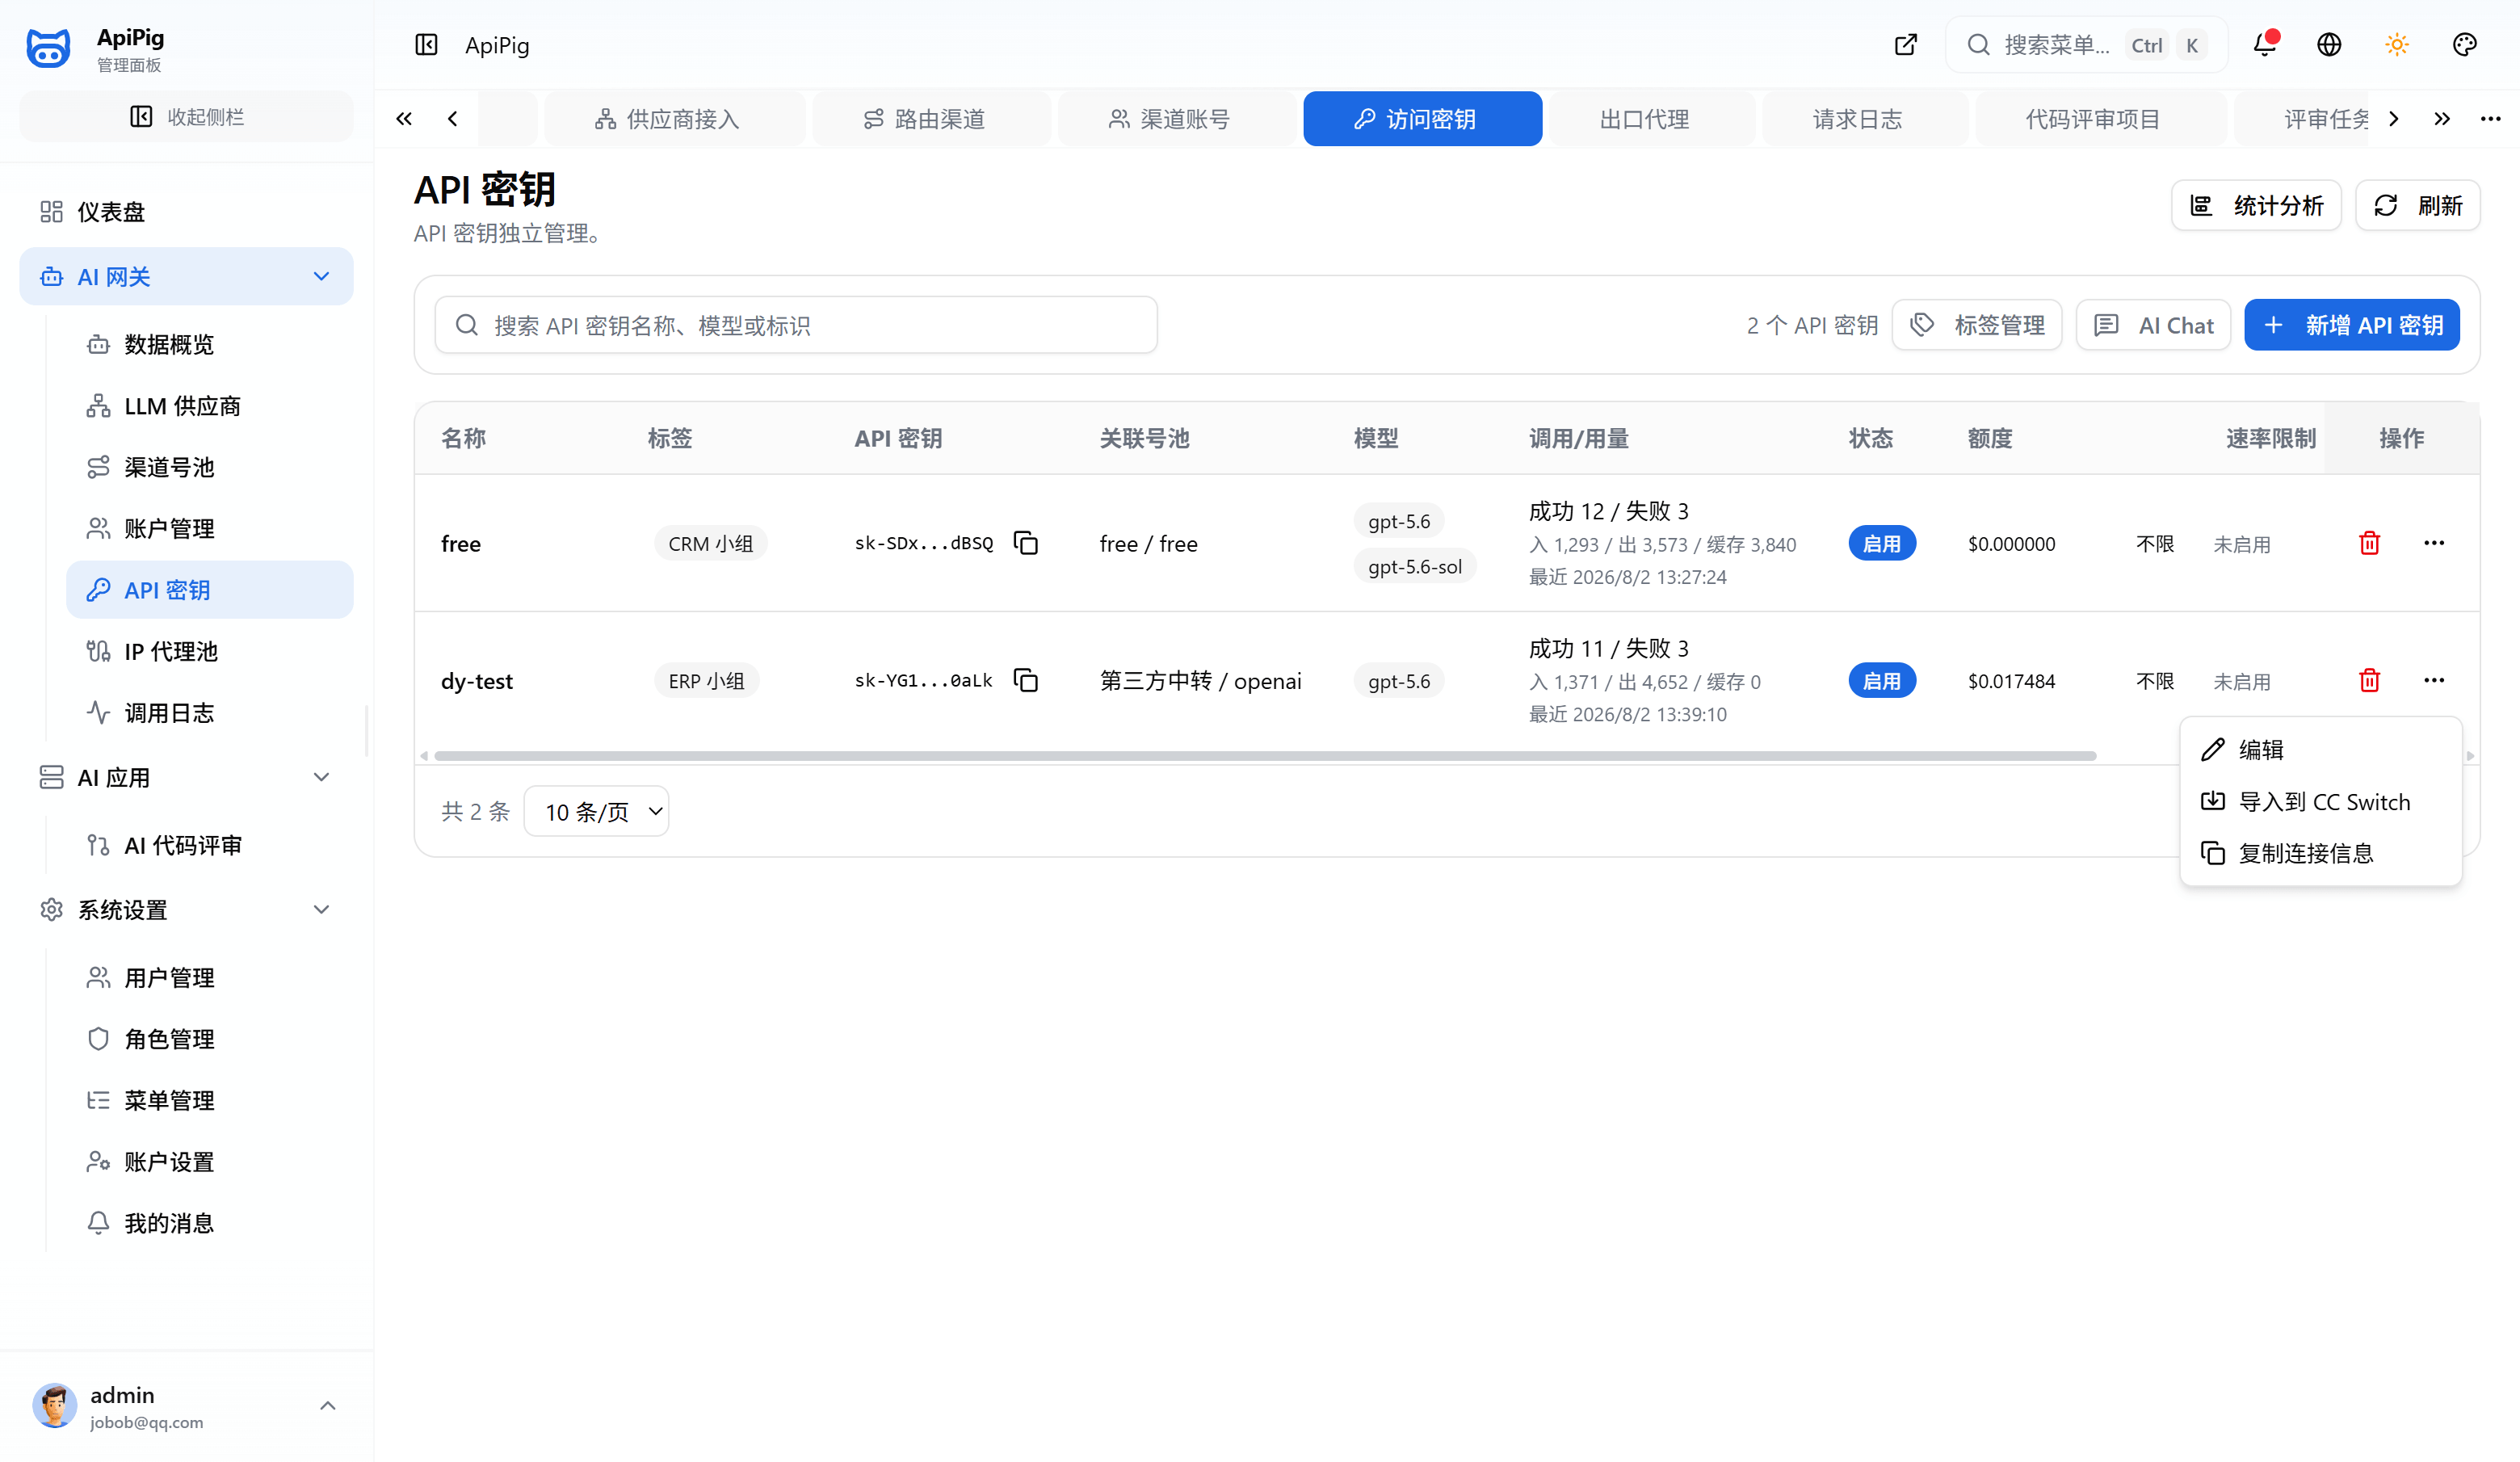
配置网关访问密钥时,可以添加 关联标签 区分不同业务或使用方。添加标签前,请先在 标签管理 中完成维护。
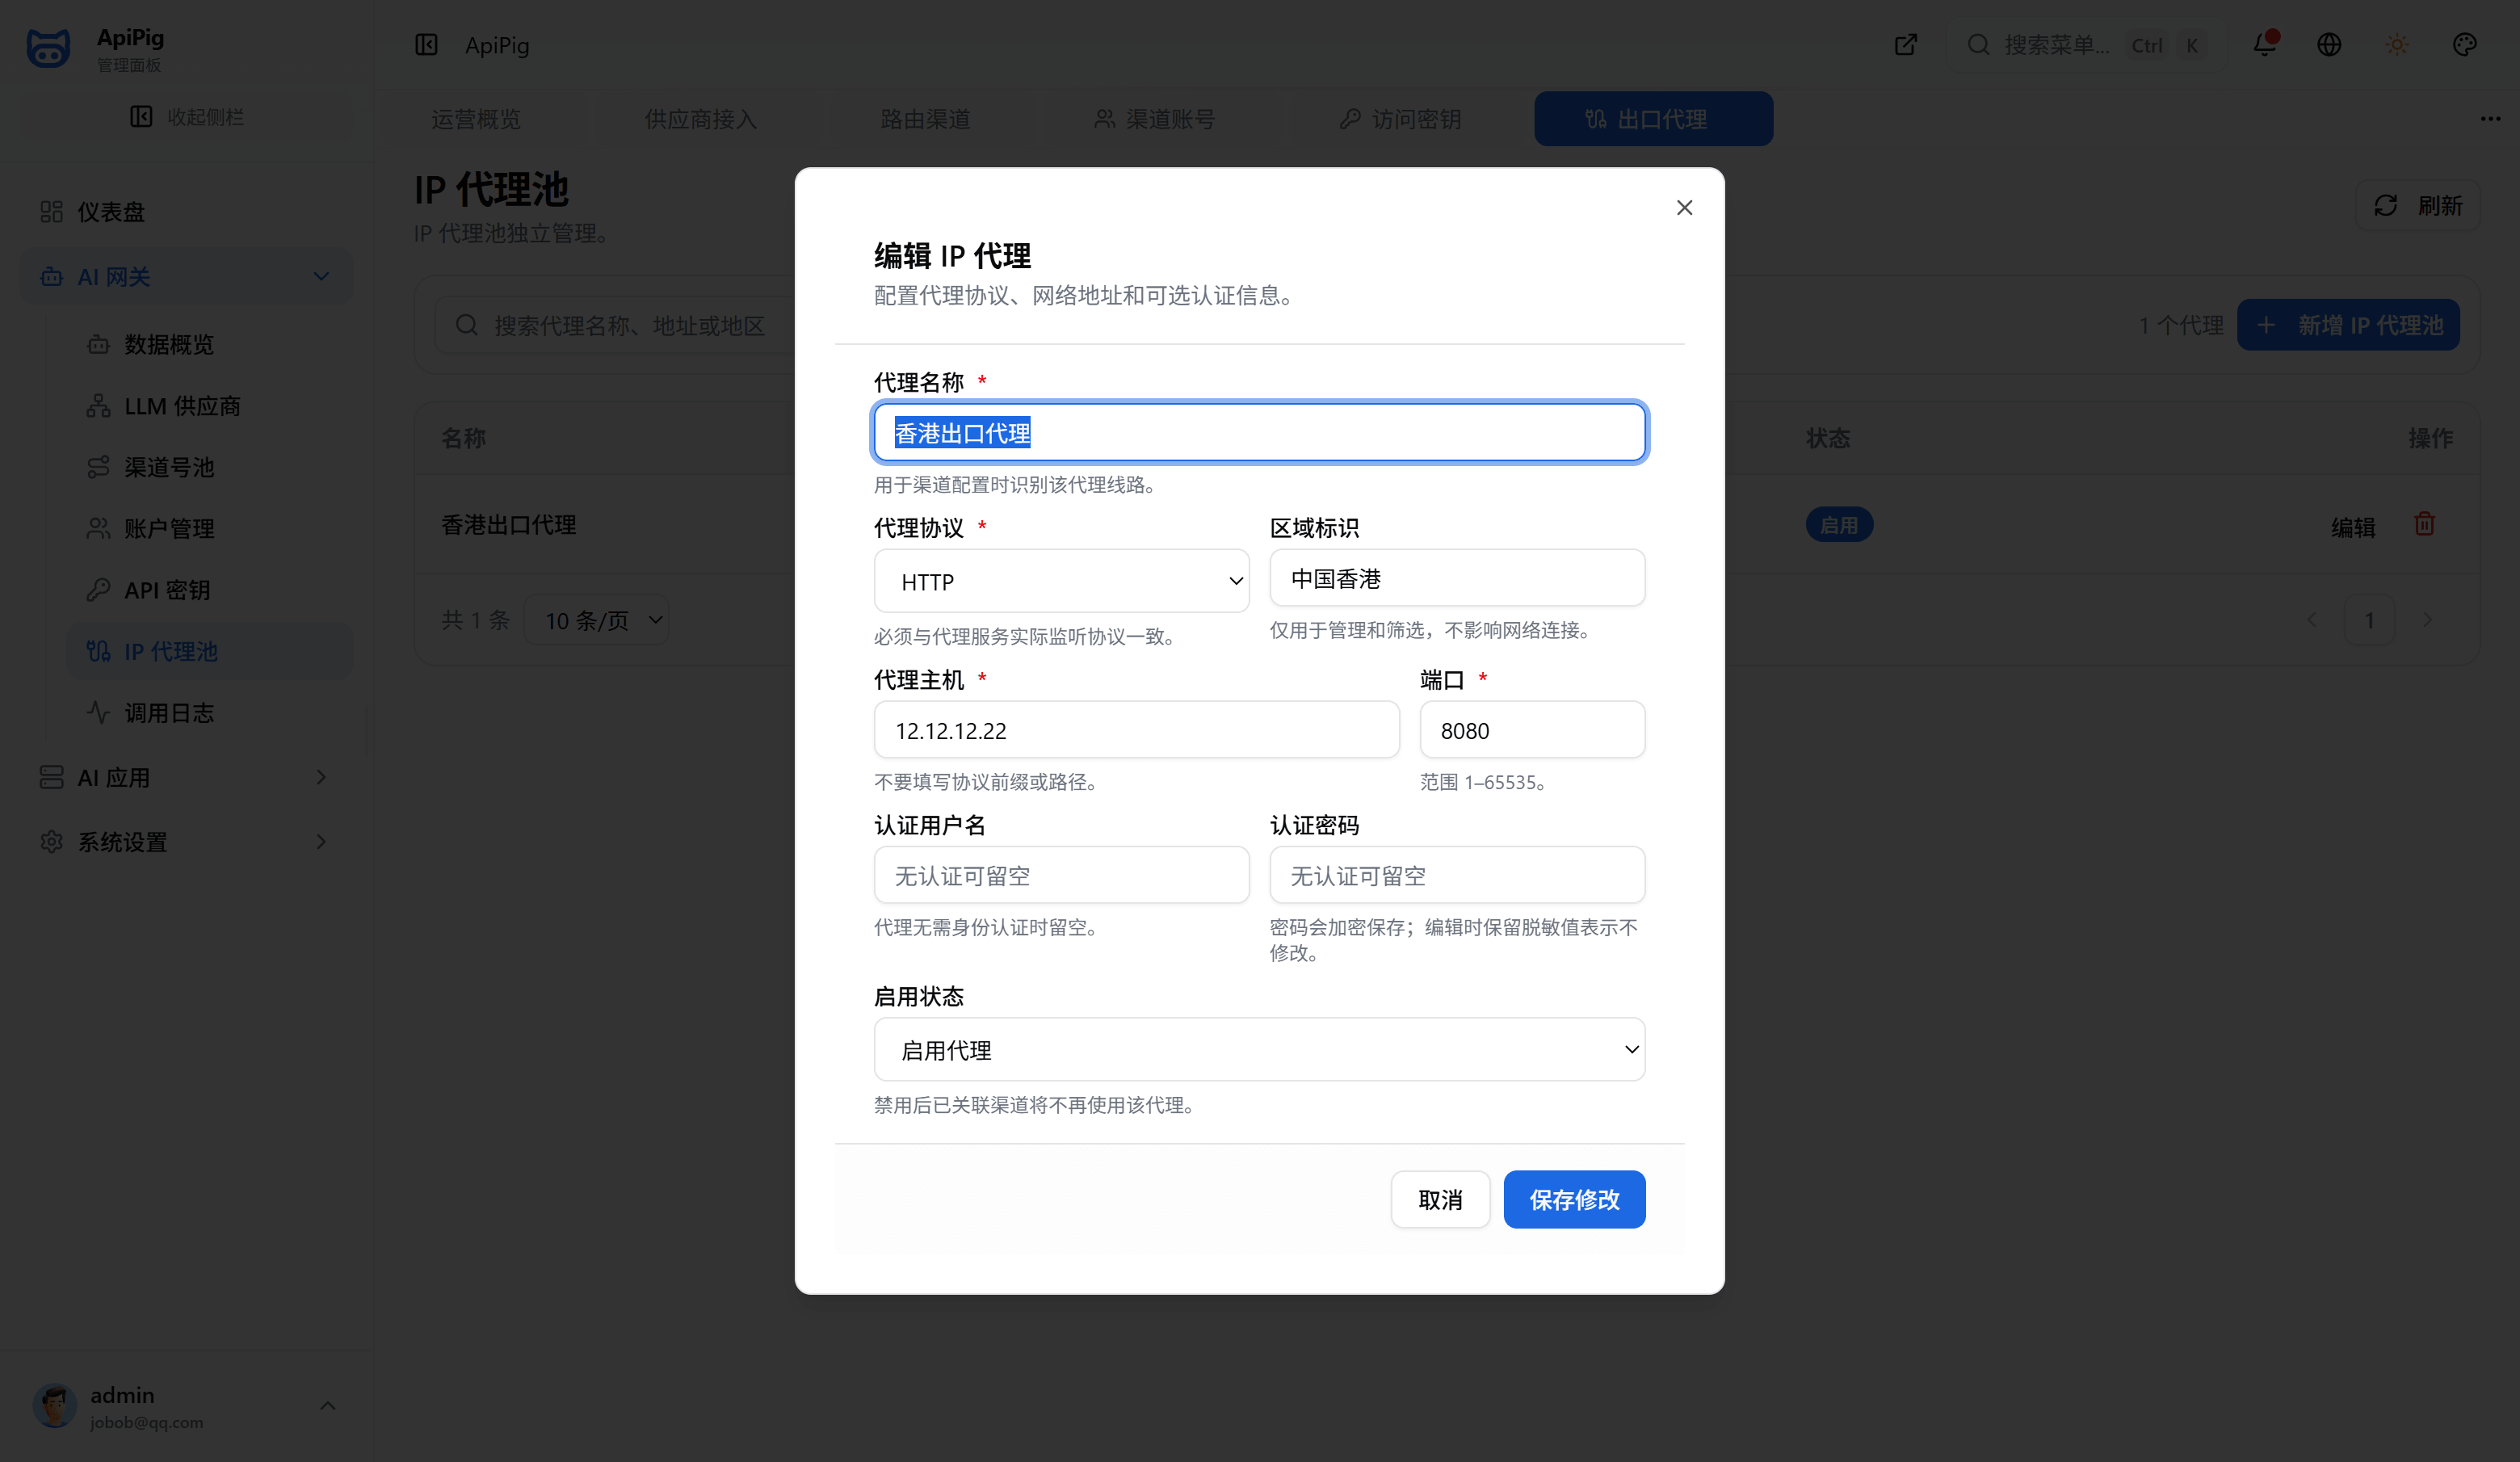
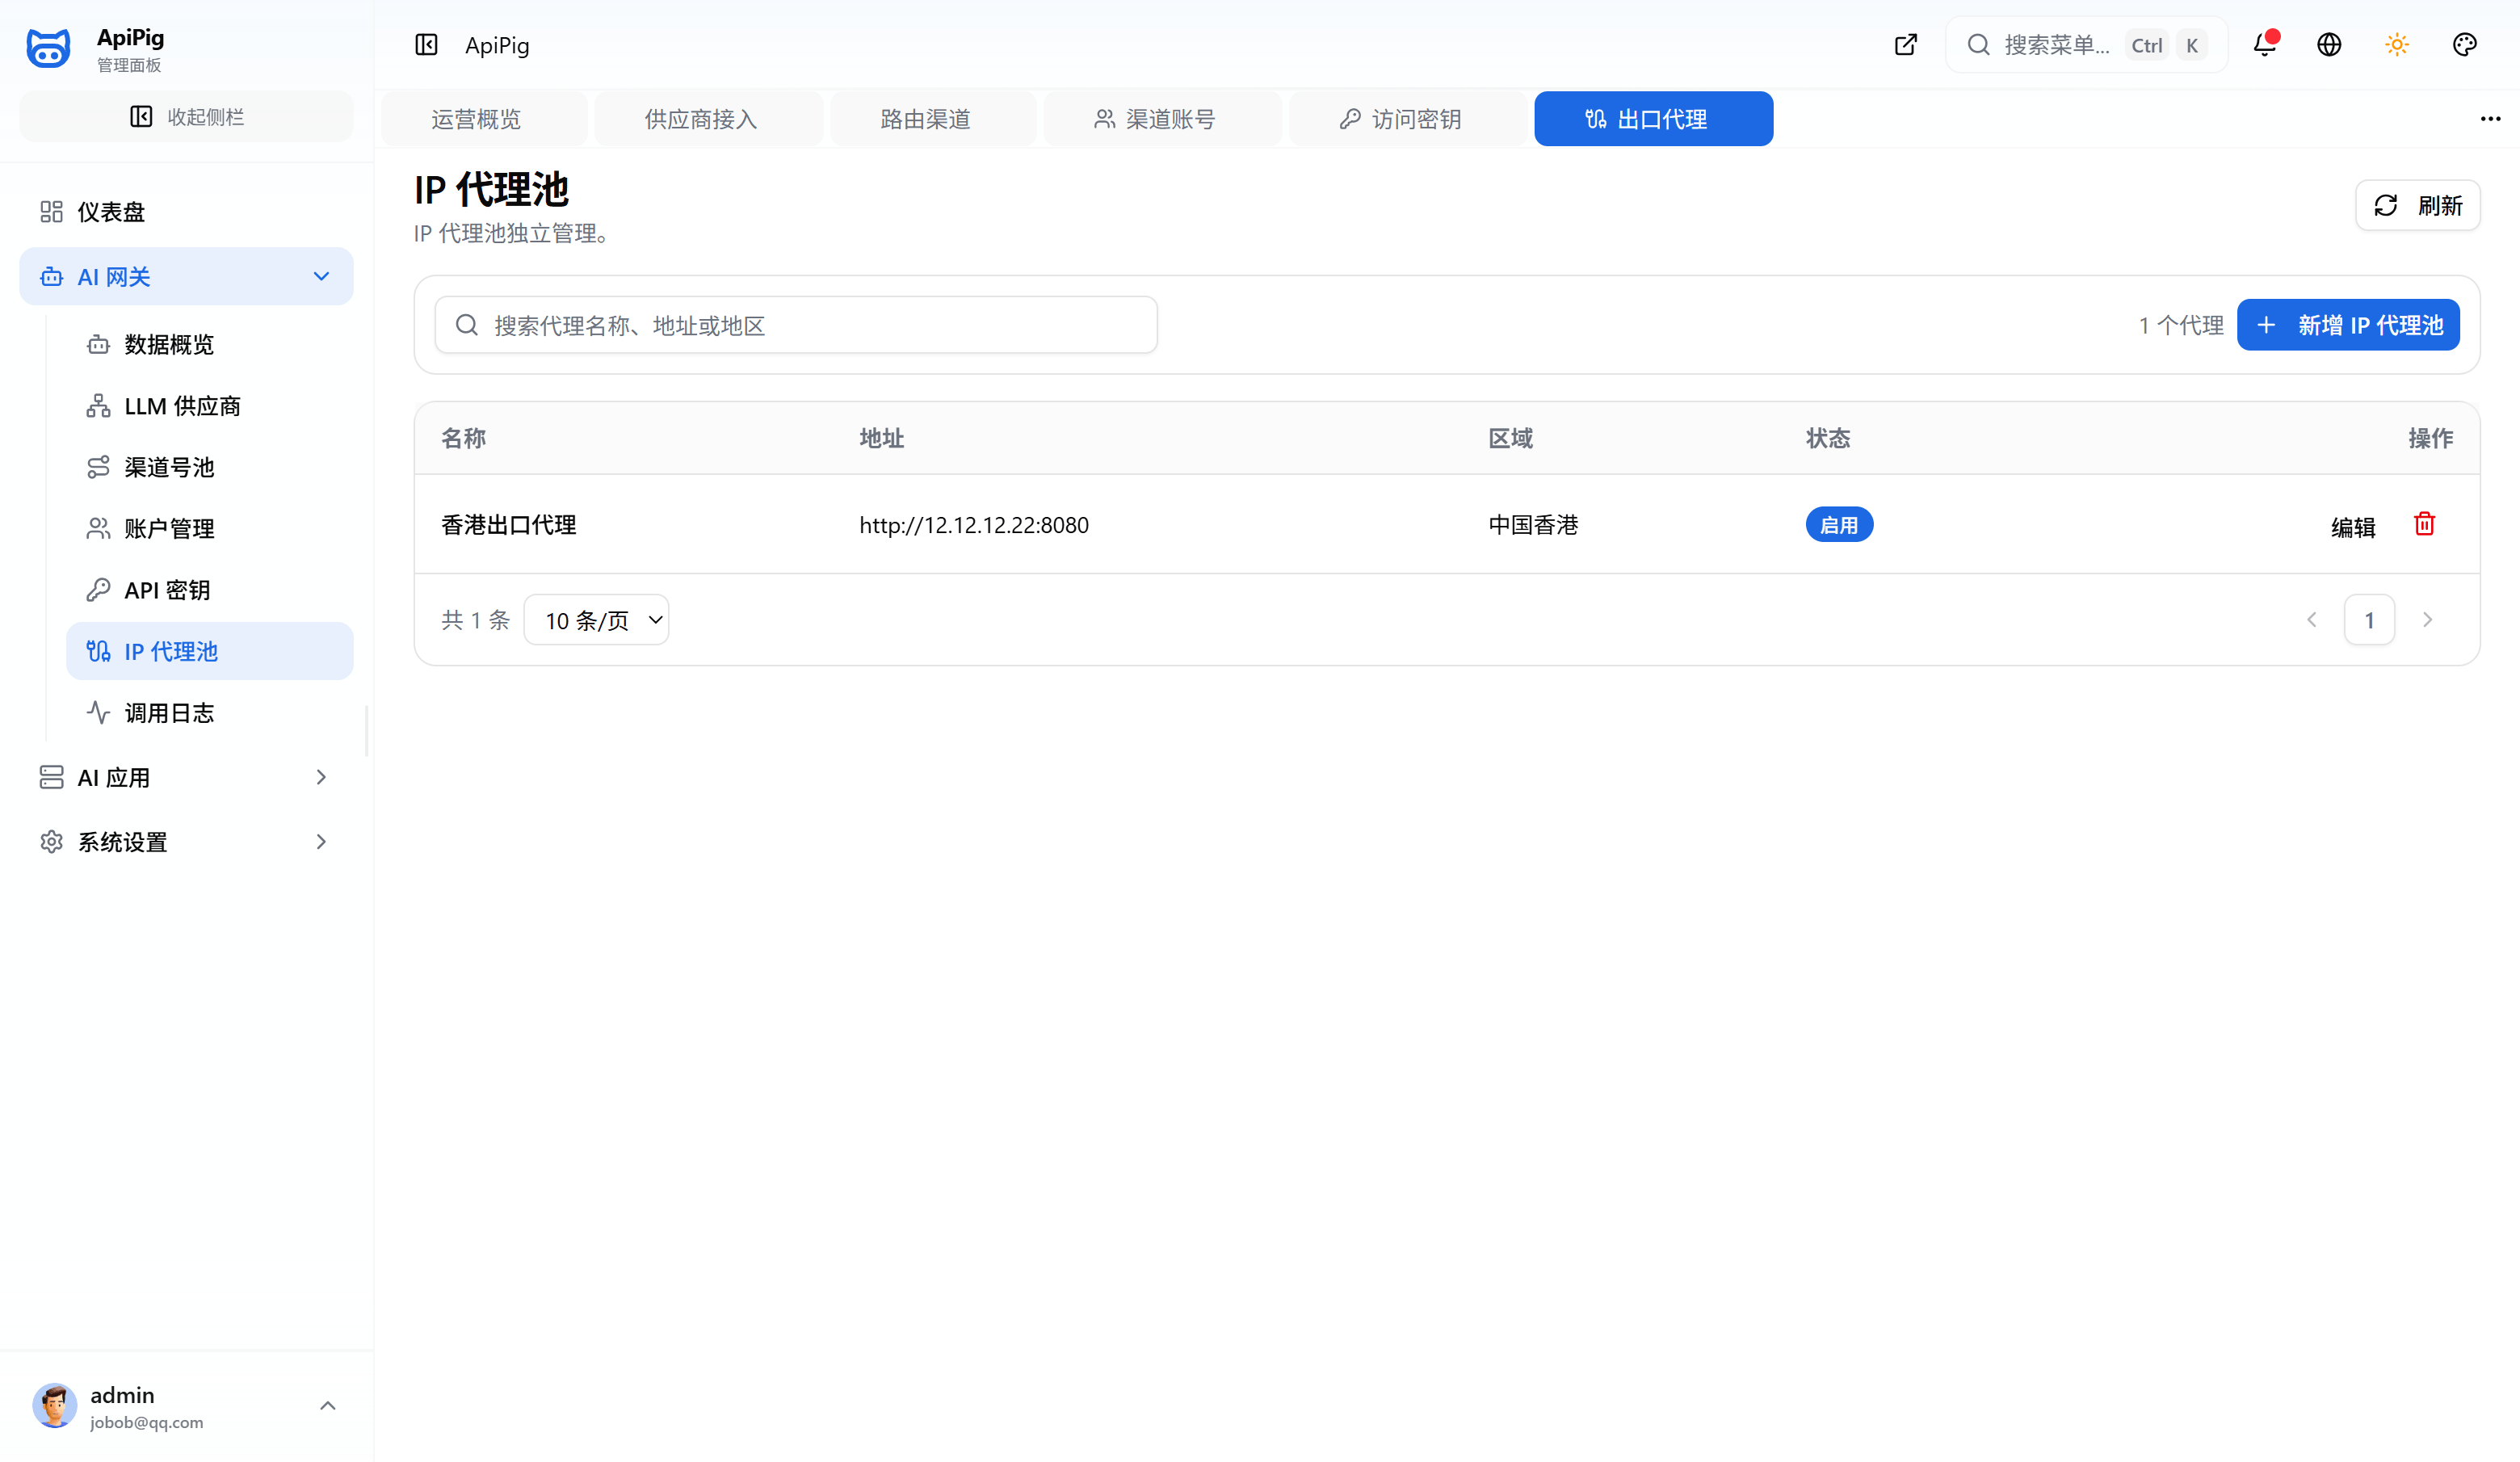
配置 IP 代理池
如果某些渠道对来源 IP 有要求,或需要固定的 IP 环境,可以配置 IP 代理池,以提升相关调用的可用性和稳定性。
查看调用日志
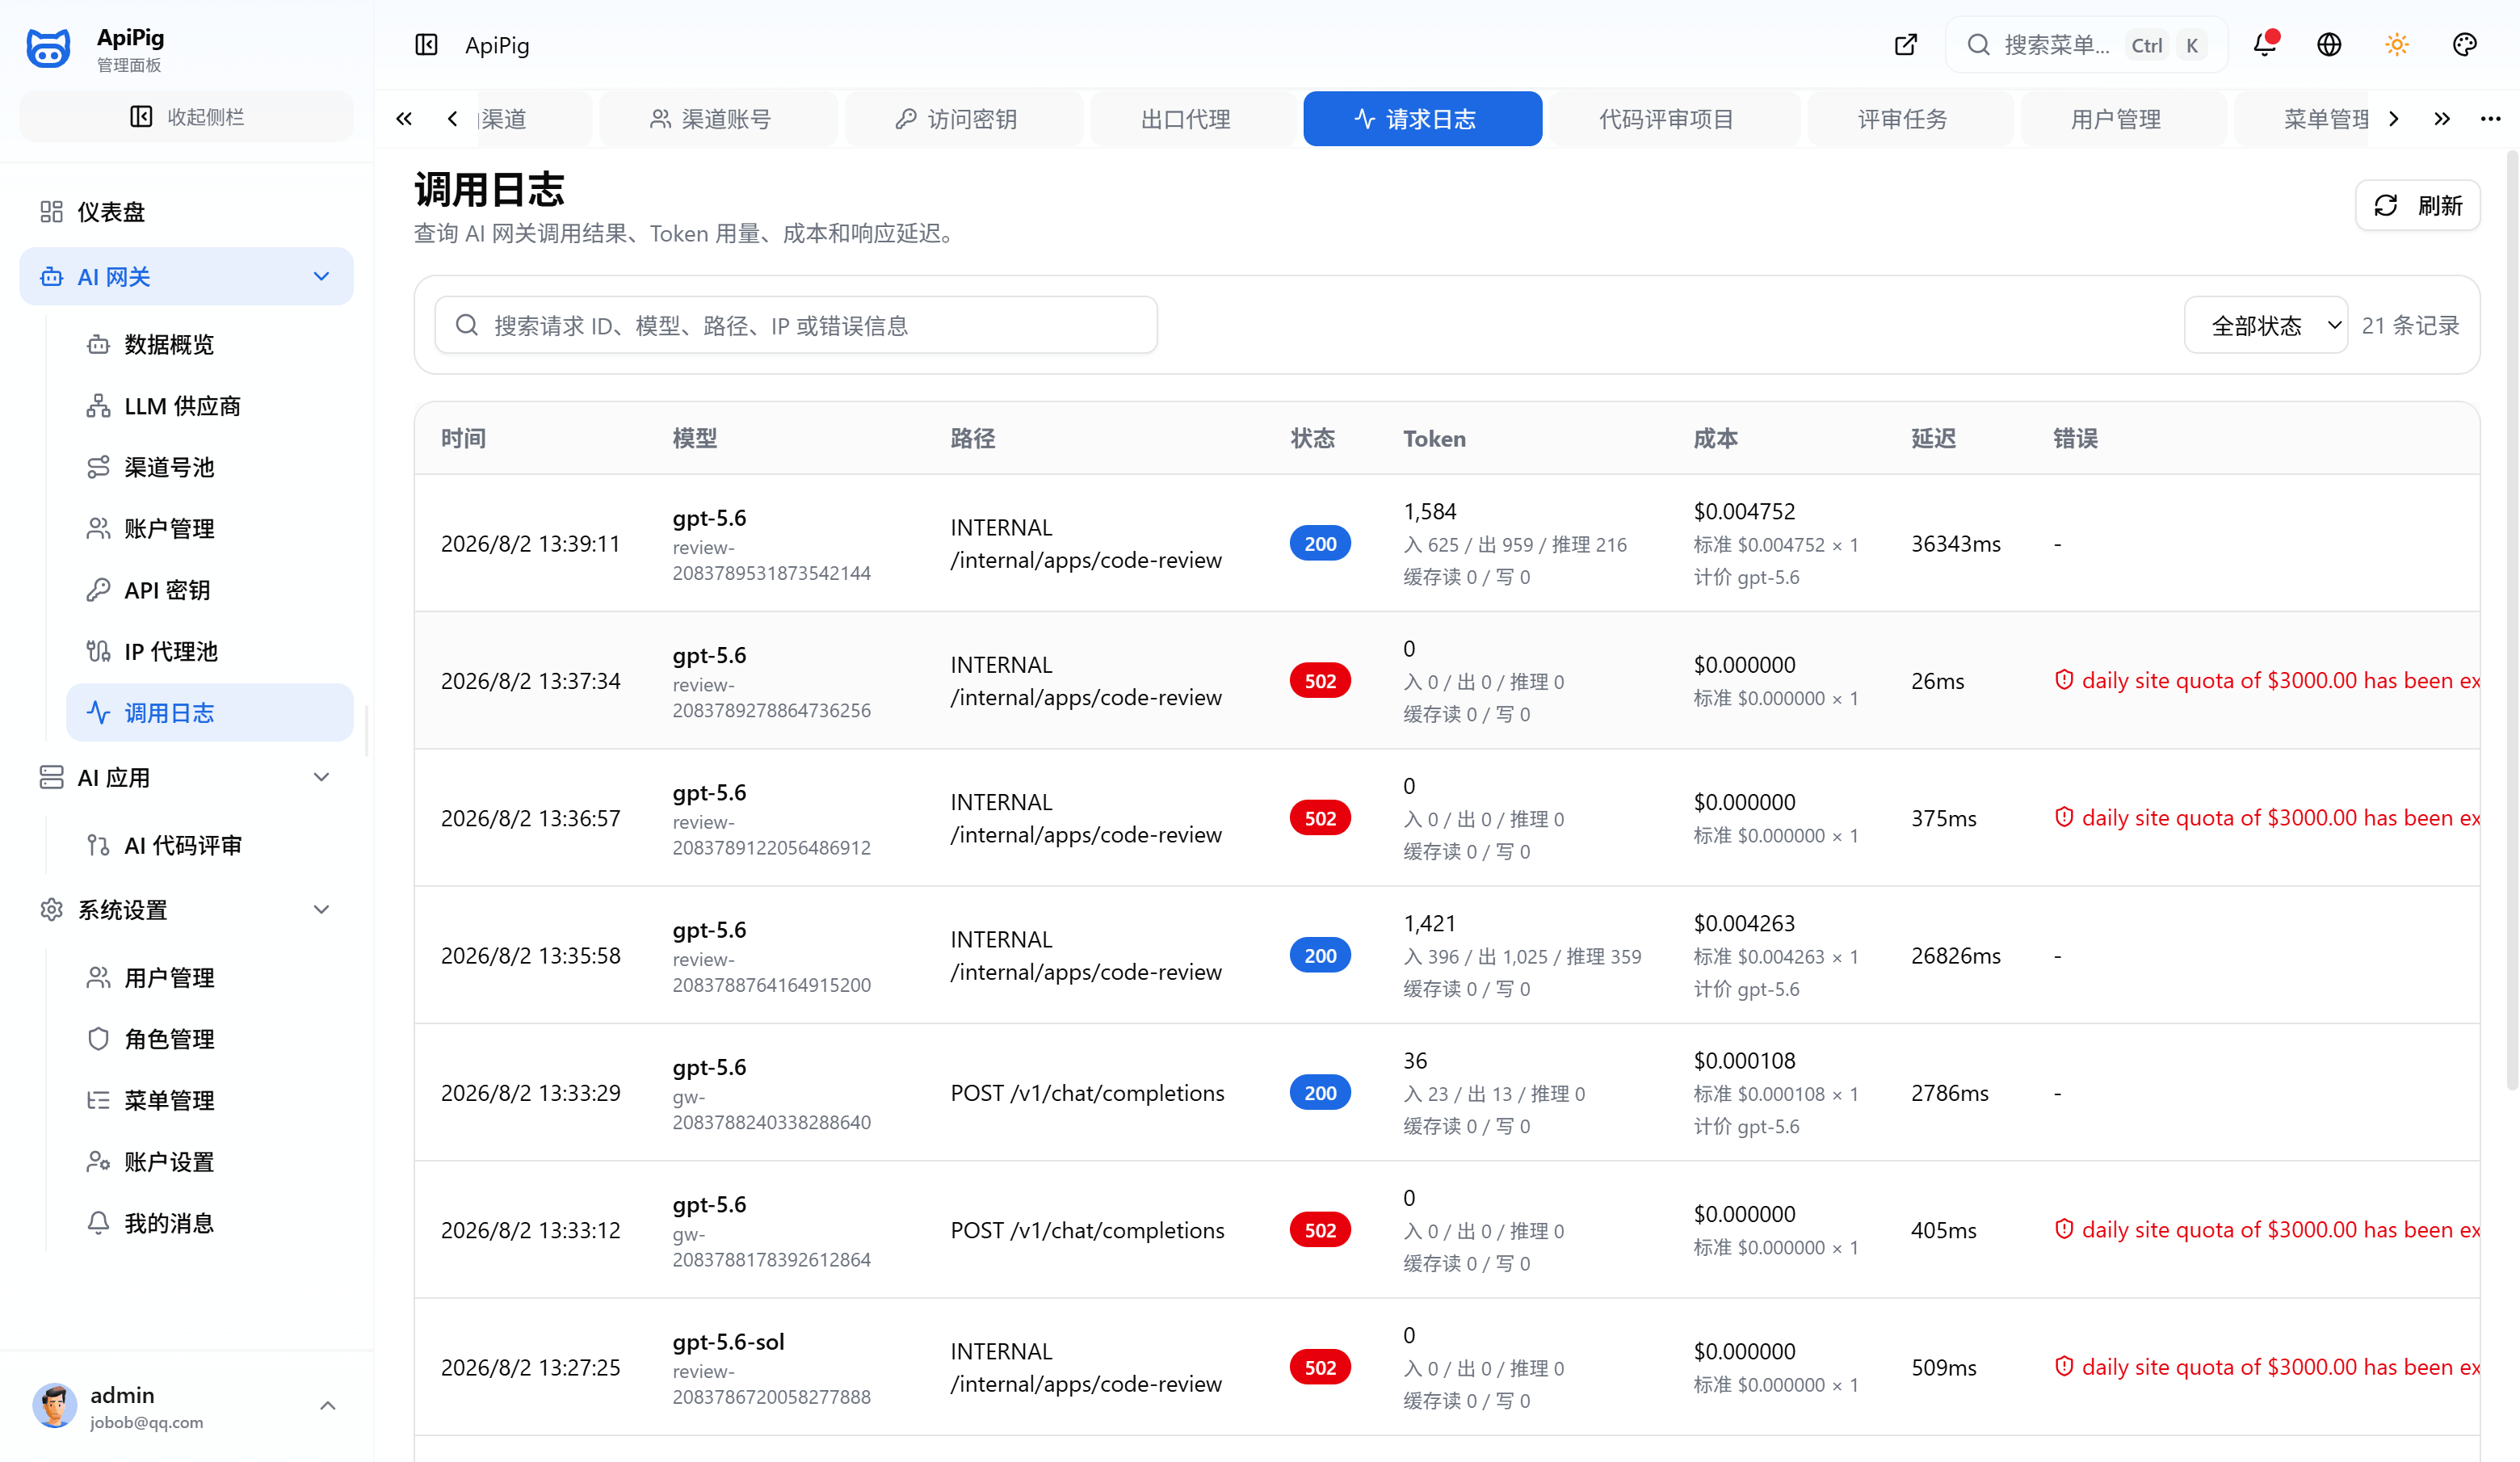
完成模型接入后,可以通过调用日志查看请求状态、响应耗时和模型使用情况,帮助定位配置问题并核对用量统计。
完成模型接入后,建议继续阅读 密钥托管,将上游凭证集中保管在平台侧。